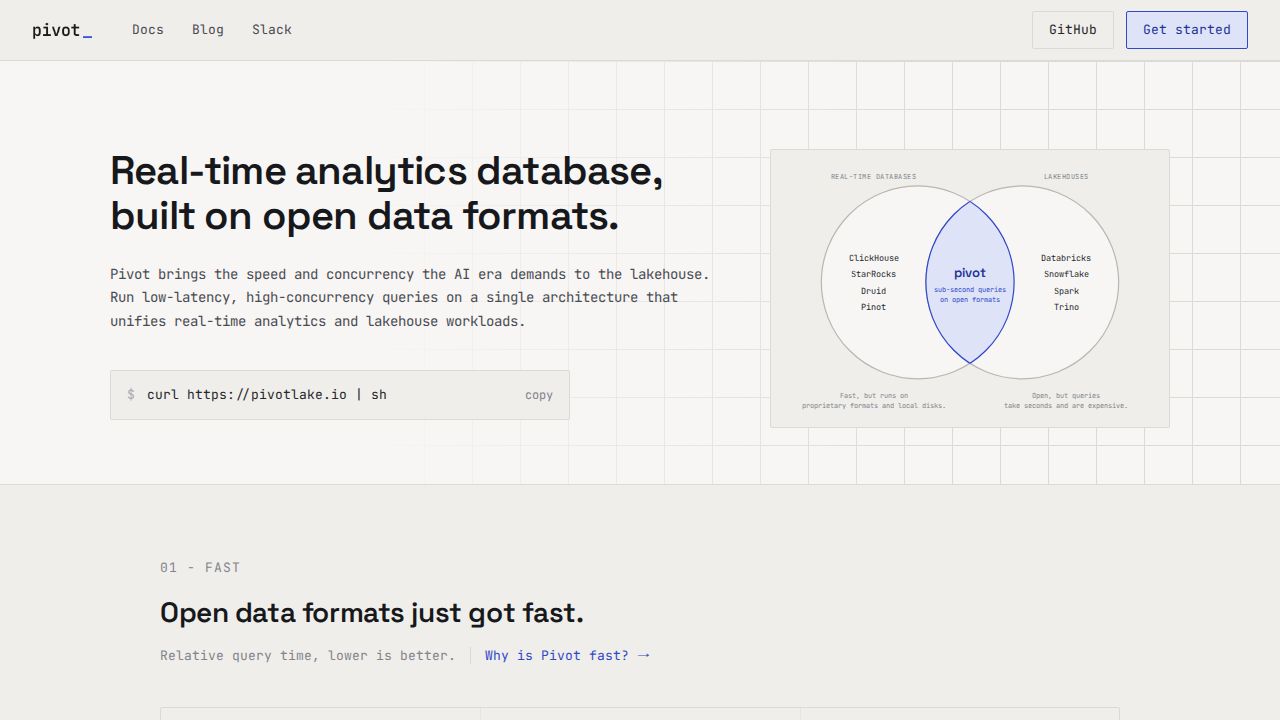
Pivot 是一个开源分析数据库,使用户能够直接在 Apache Iceberg 和 Delta Lake 等开放数据格式上运行低延迟、高并发的 SQL 查询,无需先将数据复制到专有引擎。它在端口 5432 上使用 Postgres 协议,因此现有的 SQL 客户端、商业智能工具和 AI 代理可以通过 psql 或任何 Postgres 兼容驱动程序连接,并查询仍存储在对象存储中的数据。
项目文档中的性能测量显示 Pivot 胜过已建立的分析数据库。在 ClickBench 43 查询套件中,Pivot(Parquet)的相对时间为 1.09×,而 ClickHouse(原生)为 2.17×,DuckDB(原生)为 4.17×——这意味着 Pivot 大致比 ClickHouse 快两倍,比 DuckDB 快近四倍。在 TPC‑H SF1000 基准测试中,Pivot(Parquet)设定基准为 1.00×,DuckDB(Parquet)为 2.16×,ClickHouse(原生)为 3.10×,Spark 为 53.73×。项目将这些得益归因于基于 Rust 的引擎,该引擎使用 Arrow 进行内存数据处理,采用 thread‑per‑core 执行模型,使用自定义内存分配器,并经过调优的 JOIN 和 GROUP BY 算法,以最大化现代 CPU 内存带宽。
除了速度,Pivot 强调运营灵活性和开放性。由于它将对象存储视为唯一的事实来源,仅在内存中保留短暂状态,因此实例几乎可以瞬间进行扩容、缩容或缩减至零,从而支持突发工作负载或成本节约的自动伸缩。用户可以将 Pivot 作为共享服务器运行以实现并发访问,也可以从终端本地启动以进行临时查询;两种方式均访问对象存储中的相同表格。基准测试 harness 和查询在仓库中公开可用, reported numbers 是在 AWS c8gd.metal‑48xl 实例上获得的,因此在其他硬件或工作负载下结果可能会有所不同。