openTPU 是一个开源 AI 加速器项目,在单一代码仓库中整合了 RTL、ISA、模拟器、编译器和性能分析工具。根据其文档,该项目探索 AI 代理在硬件设计方面能走多远,以及它们是否能创造出能够运行自身推理的芯片。整个加速器实现位于一个仓库中,包含 SystemVerilog 硬件设计、定义好的指令集、逐位精确的模拟器、带有编译器的自定义内核语言,以及用于驱动物理 PCIe FPGA 卡(Inspur YPCB-00338,搭载 Xilinx Kintex-7 xc7k480t 和两个 DDR3 通道)的主机软件。
此图展示文中所述的 openTPU 单一代码仓库,包含硬件设计、指令集、模拟器、编译器和性能分析工具。
该加速器采用简单的执行模型:定序器每周期向各单元发出一条指令,分别用于 DMA、矩阵乘法(从 DRAM 流式传输 int8 权重)、向量运算(fp32)和量化,不设缓存,也无隐藏调度。性能测量显示,FPGA 卡实现的令牌生成速率与模拟器相当,硬件产生的输出令牌序列与模拟器逐位完全一致。例如,以 int8 精度运行 LFM2.5-230M 模型时,设备端达到 59.0 tokens/秒,实际墙钟时间为 52.3 tokens/秒,同时利用了 85% 的可用 DRAM 带宽。采用项目的量化方案与 Hugging Face transformers 对比验证显示,Qwen3-0.6B 和 LFM2.5-230M 等模型的 top-1 一致性超过 96%,KL 散度很低。
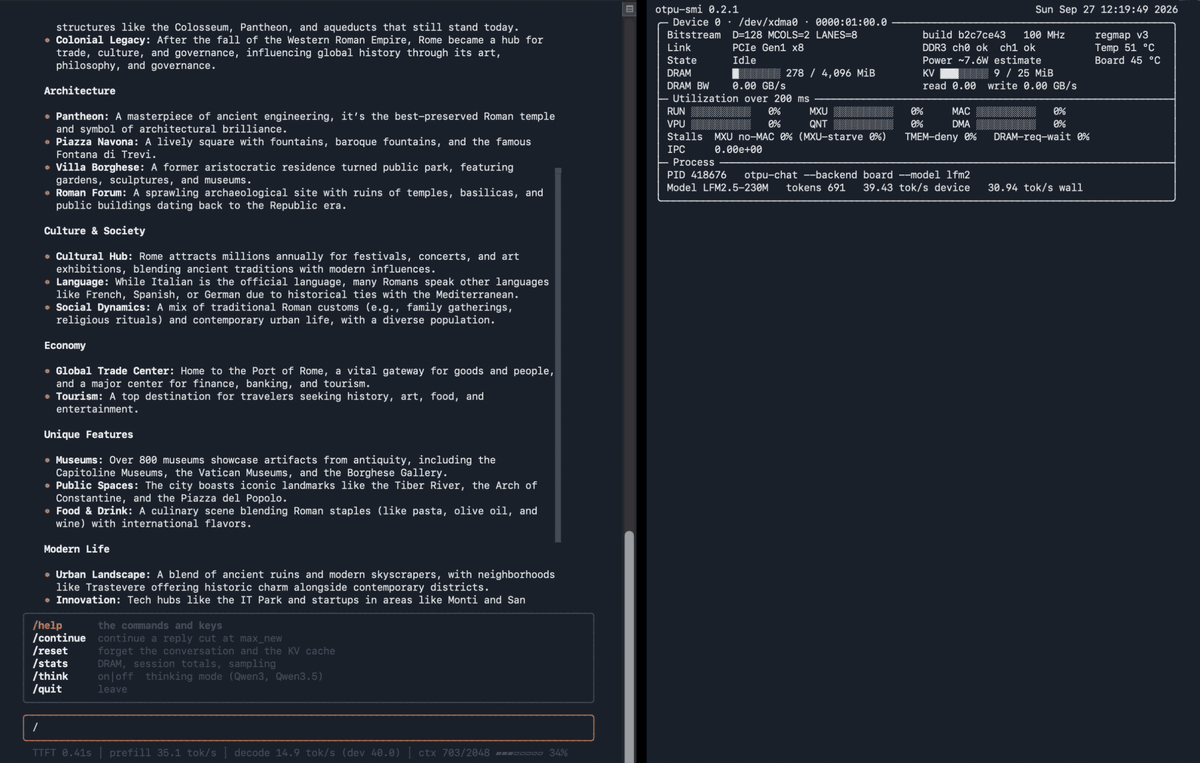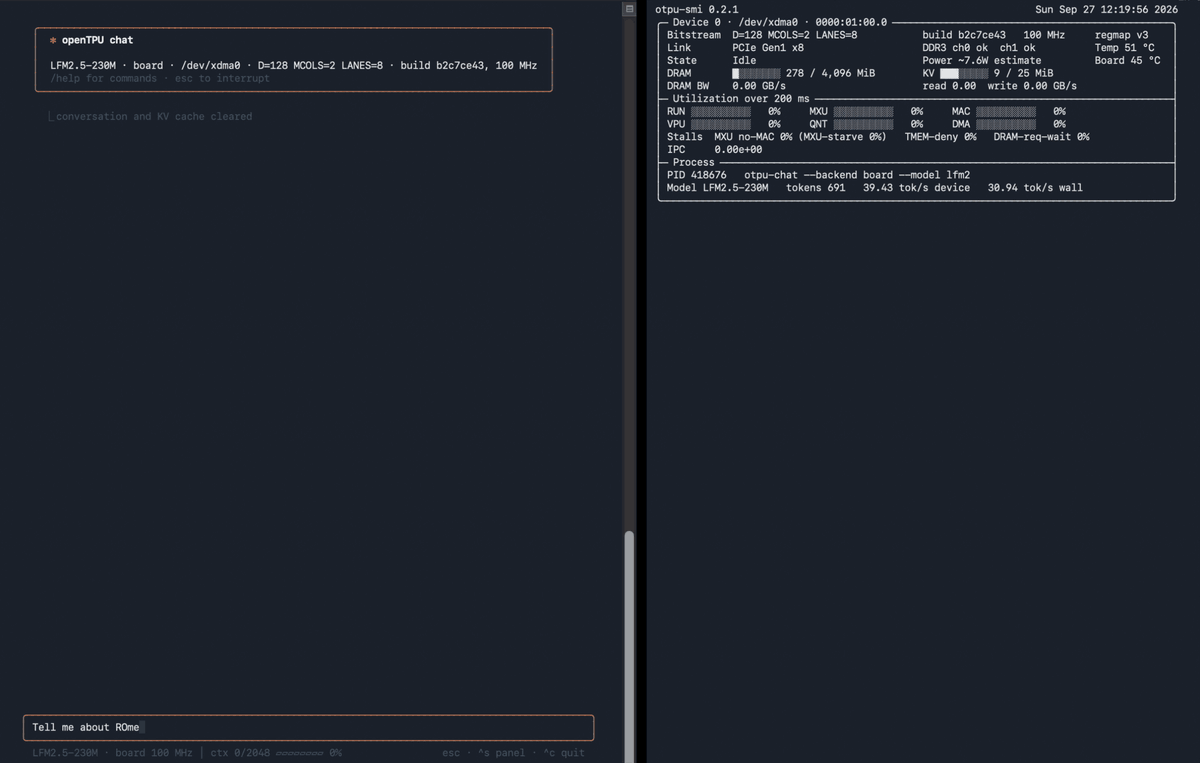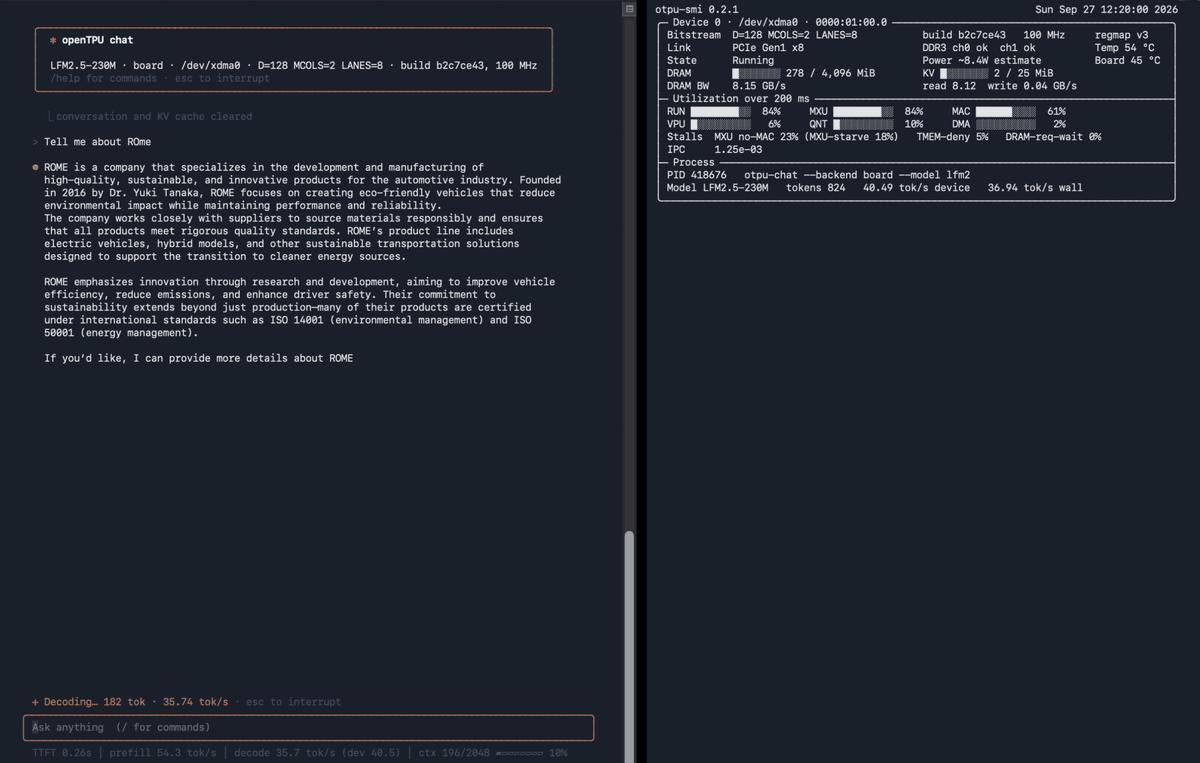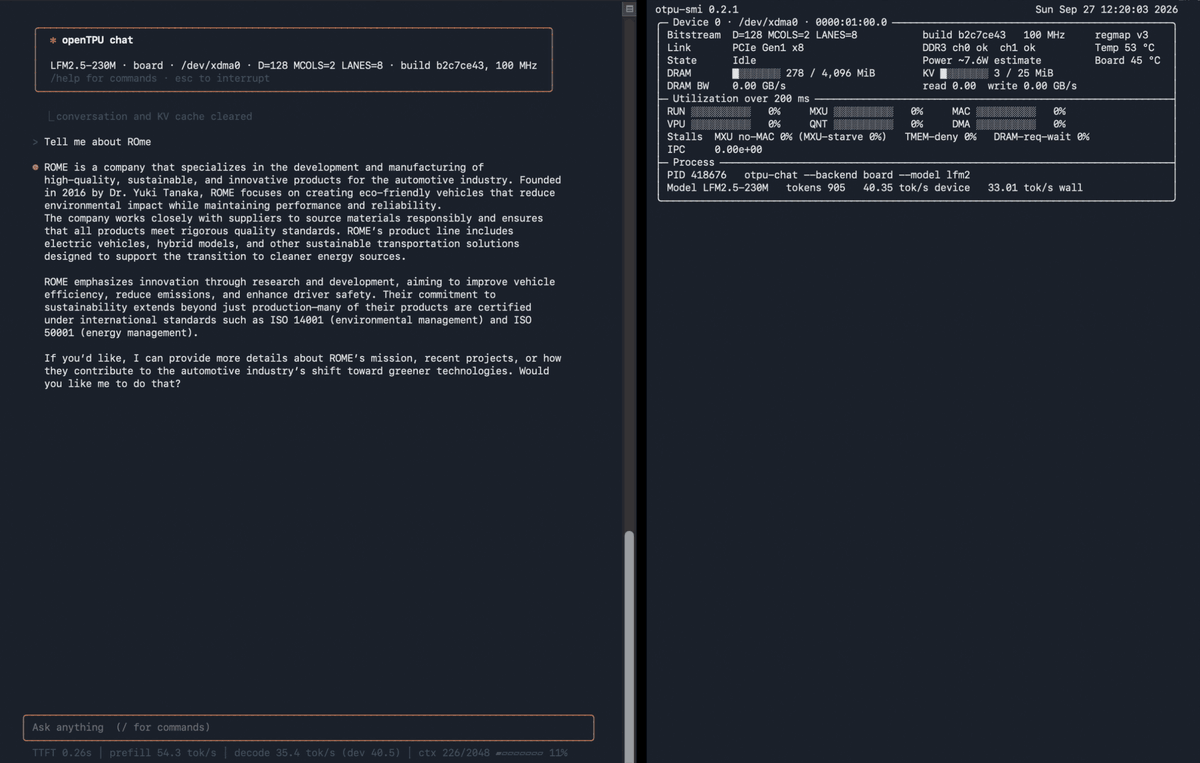
此图演示 openTPU 加速器运行量化语言模型的真实性能,对应文中关于令牌生成速率和模拟器逐位一致输出的讨论。
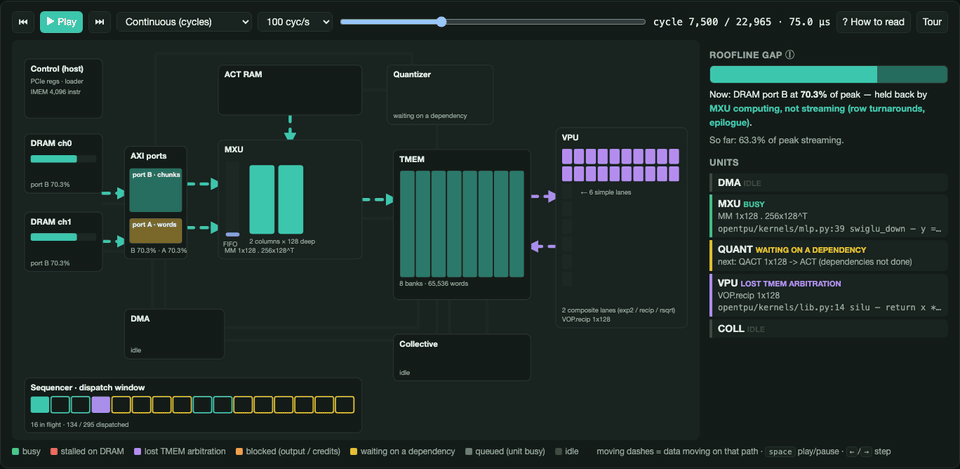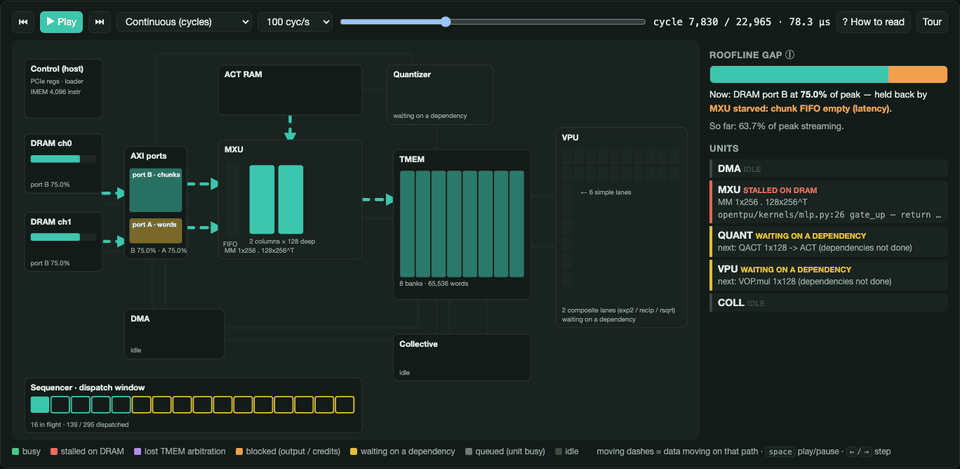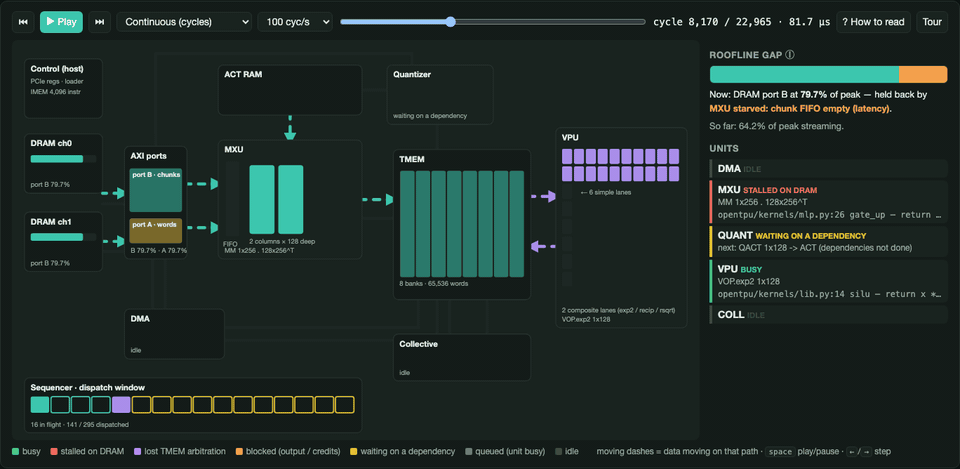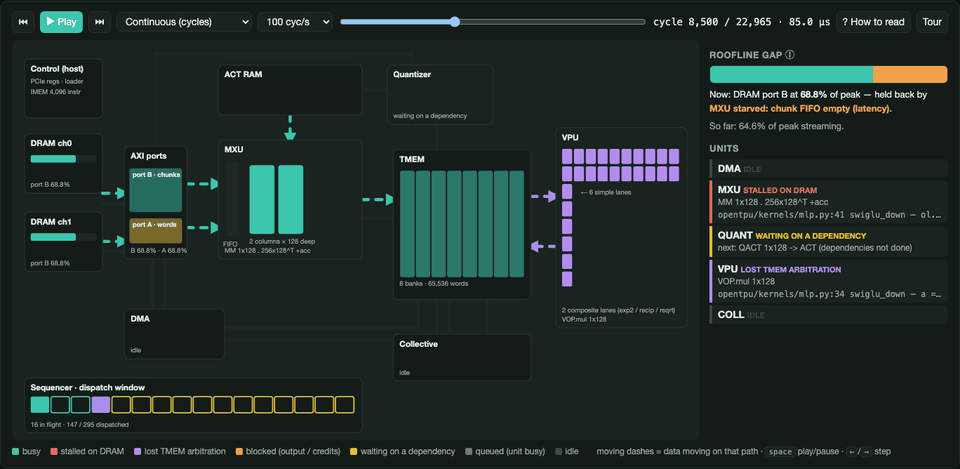
此图展示硬件平面图和解码步骤的运行时行为,支持文中提到的逐位精确模拟器和 Qwen3 执行。
存在局限和权衡:对于超出该卡 4 GiB DRAM 的混合专家模型(如 Qwen3.5-35B-A3B),专家需从主机存储经 PCIe 流式传输,速率高达每令牌 153 MB;4 位权重量化将内存占用减少约三分之一,解码速度提升 40%-45%,但会带来文档中报告的可测度困惑度损失;且某些操作(如 Qwen3.5 的预填充)仍需主机侧在执行前编译每个块的程序,表明主机并未完全退出所有工作负载的循环。