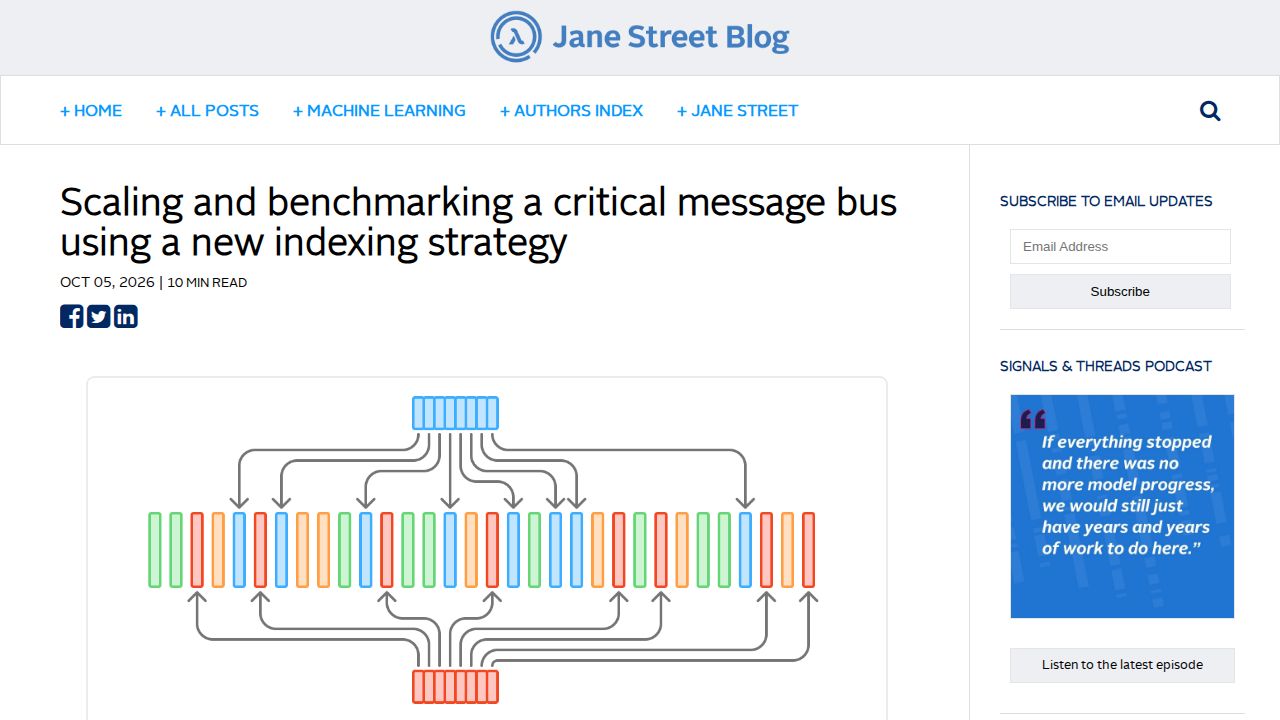
Jane Street 的内部消息框架 Aria 每日处理数 TB 数据,为订阅客户端提供实时消息流。随着 Aria 的使用增长,系统在两种恢复过程中遇到了性能瓶颈: tip recovery(客户端落后时从内存环形缓冲区请求最近消息)和 initial recovery(重启客户端从周初请求历史消息)。随着负载增加,这些操作变得吃力,促使夏季实习生 Theodor Totev 调查如何使消息过滤更高效。
为了加速 tip recovery,Totev 为每个主题分区(即共享相同两段前缀的一组主题,例如所有以 'app/codestore' 开头的主题)引入了索引,取代了对整个流的天真线性扫描。当客户端请求消息时,Aria 使用最小堆对相关分区索引执行 n‑way 合并,以顺序重建仅需的消息流。基准测试表明,将标准堆实现替换为 fast_heap_unboxed 版本使索引恢复代码的性能翻倍,从而在生产工作负载中观察到 CPU 使用率下降 30%,同时保持系统的严格正确性要求。
对于 initial recovery,Totev 解决了另一种低效率:Aria 的磁盘存储最初根据主题名称的前三段采用简单启发式将消息段拆分到子树存储,这可能导致高流量主题与低流量主题被放在同一存储中。这导致读取小主题的客户端需要过滤掉大量无关数据,有时会读取比必要多达十倍的字节。通过分析每个主题的实际消息量,Totev 提出了一种自适应分割算法,结合贪心聚类与二分查找。该算法为消息量大的主题分配独立的子树存储,而将消息量小的主题捆绑到共享存储中,从而在特定主题读取过程中最小化浪费的字节。