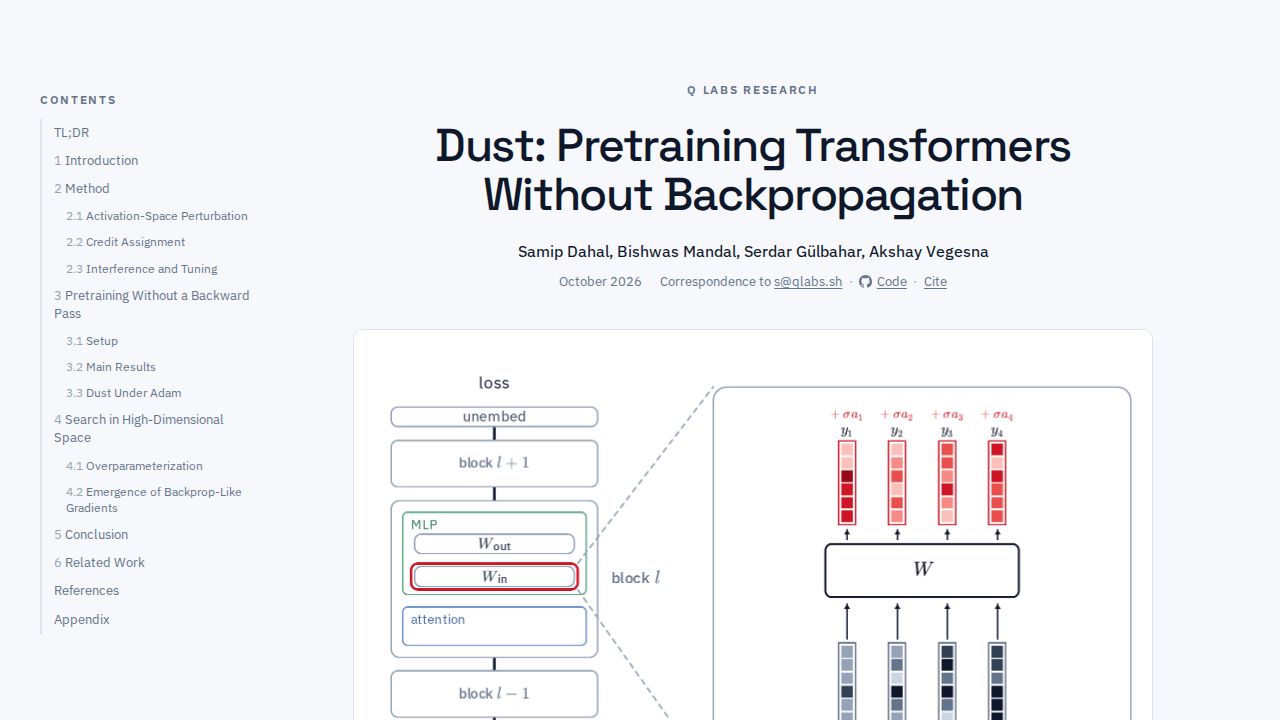
Dust 代表了与标准神经网络训练方法的根本区别。与需要可微计算并通过链式法则计算一阶梯度的反向传播不同,Dust 是一种零阶优化方法,通过直接扰动激活并测量损失变化来估计梯度。根据主要来源的描述,该方法在每个标记上独立地为每个线性层的输出添加高斯噪声,执行一次前向传播,并根据该标记处的损失变化来奖励每个标记的噪声。这种方法创造了研究人员所称的“虚拟种群”,其中每个标记成为种群成员,使得一次前向传播能够并行评估许多扰动,而无需像在权重空间中运行的传统进化策略那样为每个扰动单独进行传播。
Dust 的核心效率优势来源于其激活空间扰动方法。通过扰动激活而不是权重,Dust 避免了在权重空间中实体化每个种群成员的需求,使其相比如 EGGROLL 这样的权重空间进化策略高出几个数量级。根据主要来源,相较于 EGGROLL 的 Transformer 实现(一种最先进的进化策略),Dust 的效率高出 10^3 到 10^4 倍,这一估计基于从 1M 标记起始的外推。这种效率提升来自于在标记上并行评估扰动,而不是在种群成员上依次评估,一次前向传播即可评估比现代 Transformer 上的权重空间 ES 大至少三个数量级的种群。
实证结果表明 Dust 与既有优化方法具有竞争力。主要来源报告称,在大规模种群下,Dust 能够紧密逼近反向传播,在多种设置中甚至超过它,这暗示在计算资源丰富的情况下可能具有优势。与传统观念相反——即较大模型的种群效率较低——研究人员发现,在使用 Dust 时,较大模型实际上更具种群效率:在大多数种群规模下,拥有 2.43亿参数的模型表现优于其小 120 倍的模型。此外,随着种群规模的增加,Dust 的梯度估计与反向传播的一致性更好,在所有测试规模上(直至 10亿标记)保持良好的一致性,研究人员认为这有助于将该方法扩展到更大模型和更长的训练运行。