谷歌于 2026 年 10 月 6 日宣布 EmbeddingGemma 2 为一种开放权重的多模态嵌入模型,能够在统一的嵌入空间中处理文本、图像、音频和视频。该模型在 Apache 2.0 许可证下发布,基于 Gemma 4 架构,包含 7.4 亿参数,使得无需互联网连接即可在设备端进行跨模态搜索和检索任务的推理。
该模型具有模块化设计,开发者只需使用文本编码器(2.7 亿参数),或添加可选的视觉(1.7 亿)和音频(3 亿)编码器以获得完整的多模态支持。它采用 Matryoshka 表示学习(MRL)动态将输出向量从 768 维截断至 512、256 或 128 维,为向量数据库提供最高 6x 的存储降低。此外,其 8K 令牌上下文窗口——是第一代 EmbeddingGemma 的四倍——使得能够在本地硬件上直接处理约 5.5 分钟的音频、29 张图像或 58 个视频帧。

此图展示了 EmbeddingGemma 2 的边缘部署能力,支持文章中关于设备端推理和模块化多模态支持的讨论。
EmbeddingGemma 2 在代码性能(MTEB Code)方面较前代提升了 9.92 分,从 68.76 提升至 78.68,且在诸如谷歌 Pixel 11 Pro 等设备上运行高效:仅文本权重时占用约 191MB RAM,全多模态模型量化后占用约 567MB。虽然来源强调了其出色的参数质量比,并指出它在某些任务上的表现优于一些大小超过它两倍的专家模型,但未提供图像、音频或视频任务的模态特定性能细节,因此这些领域的确切提升未被具体说明。
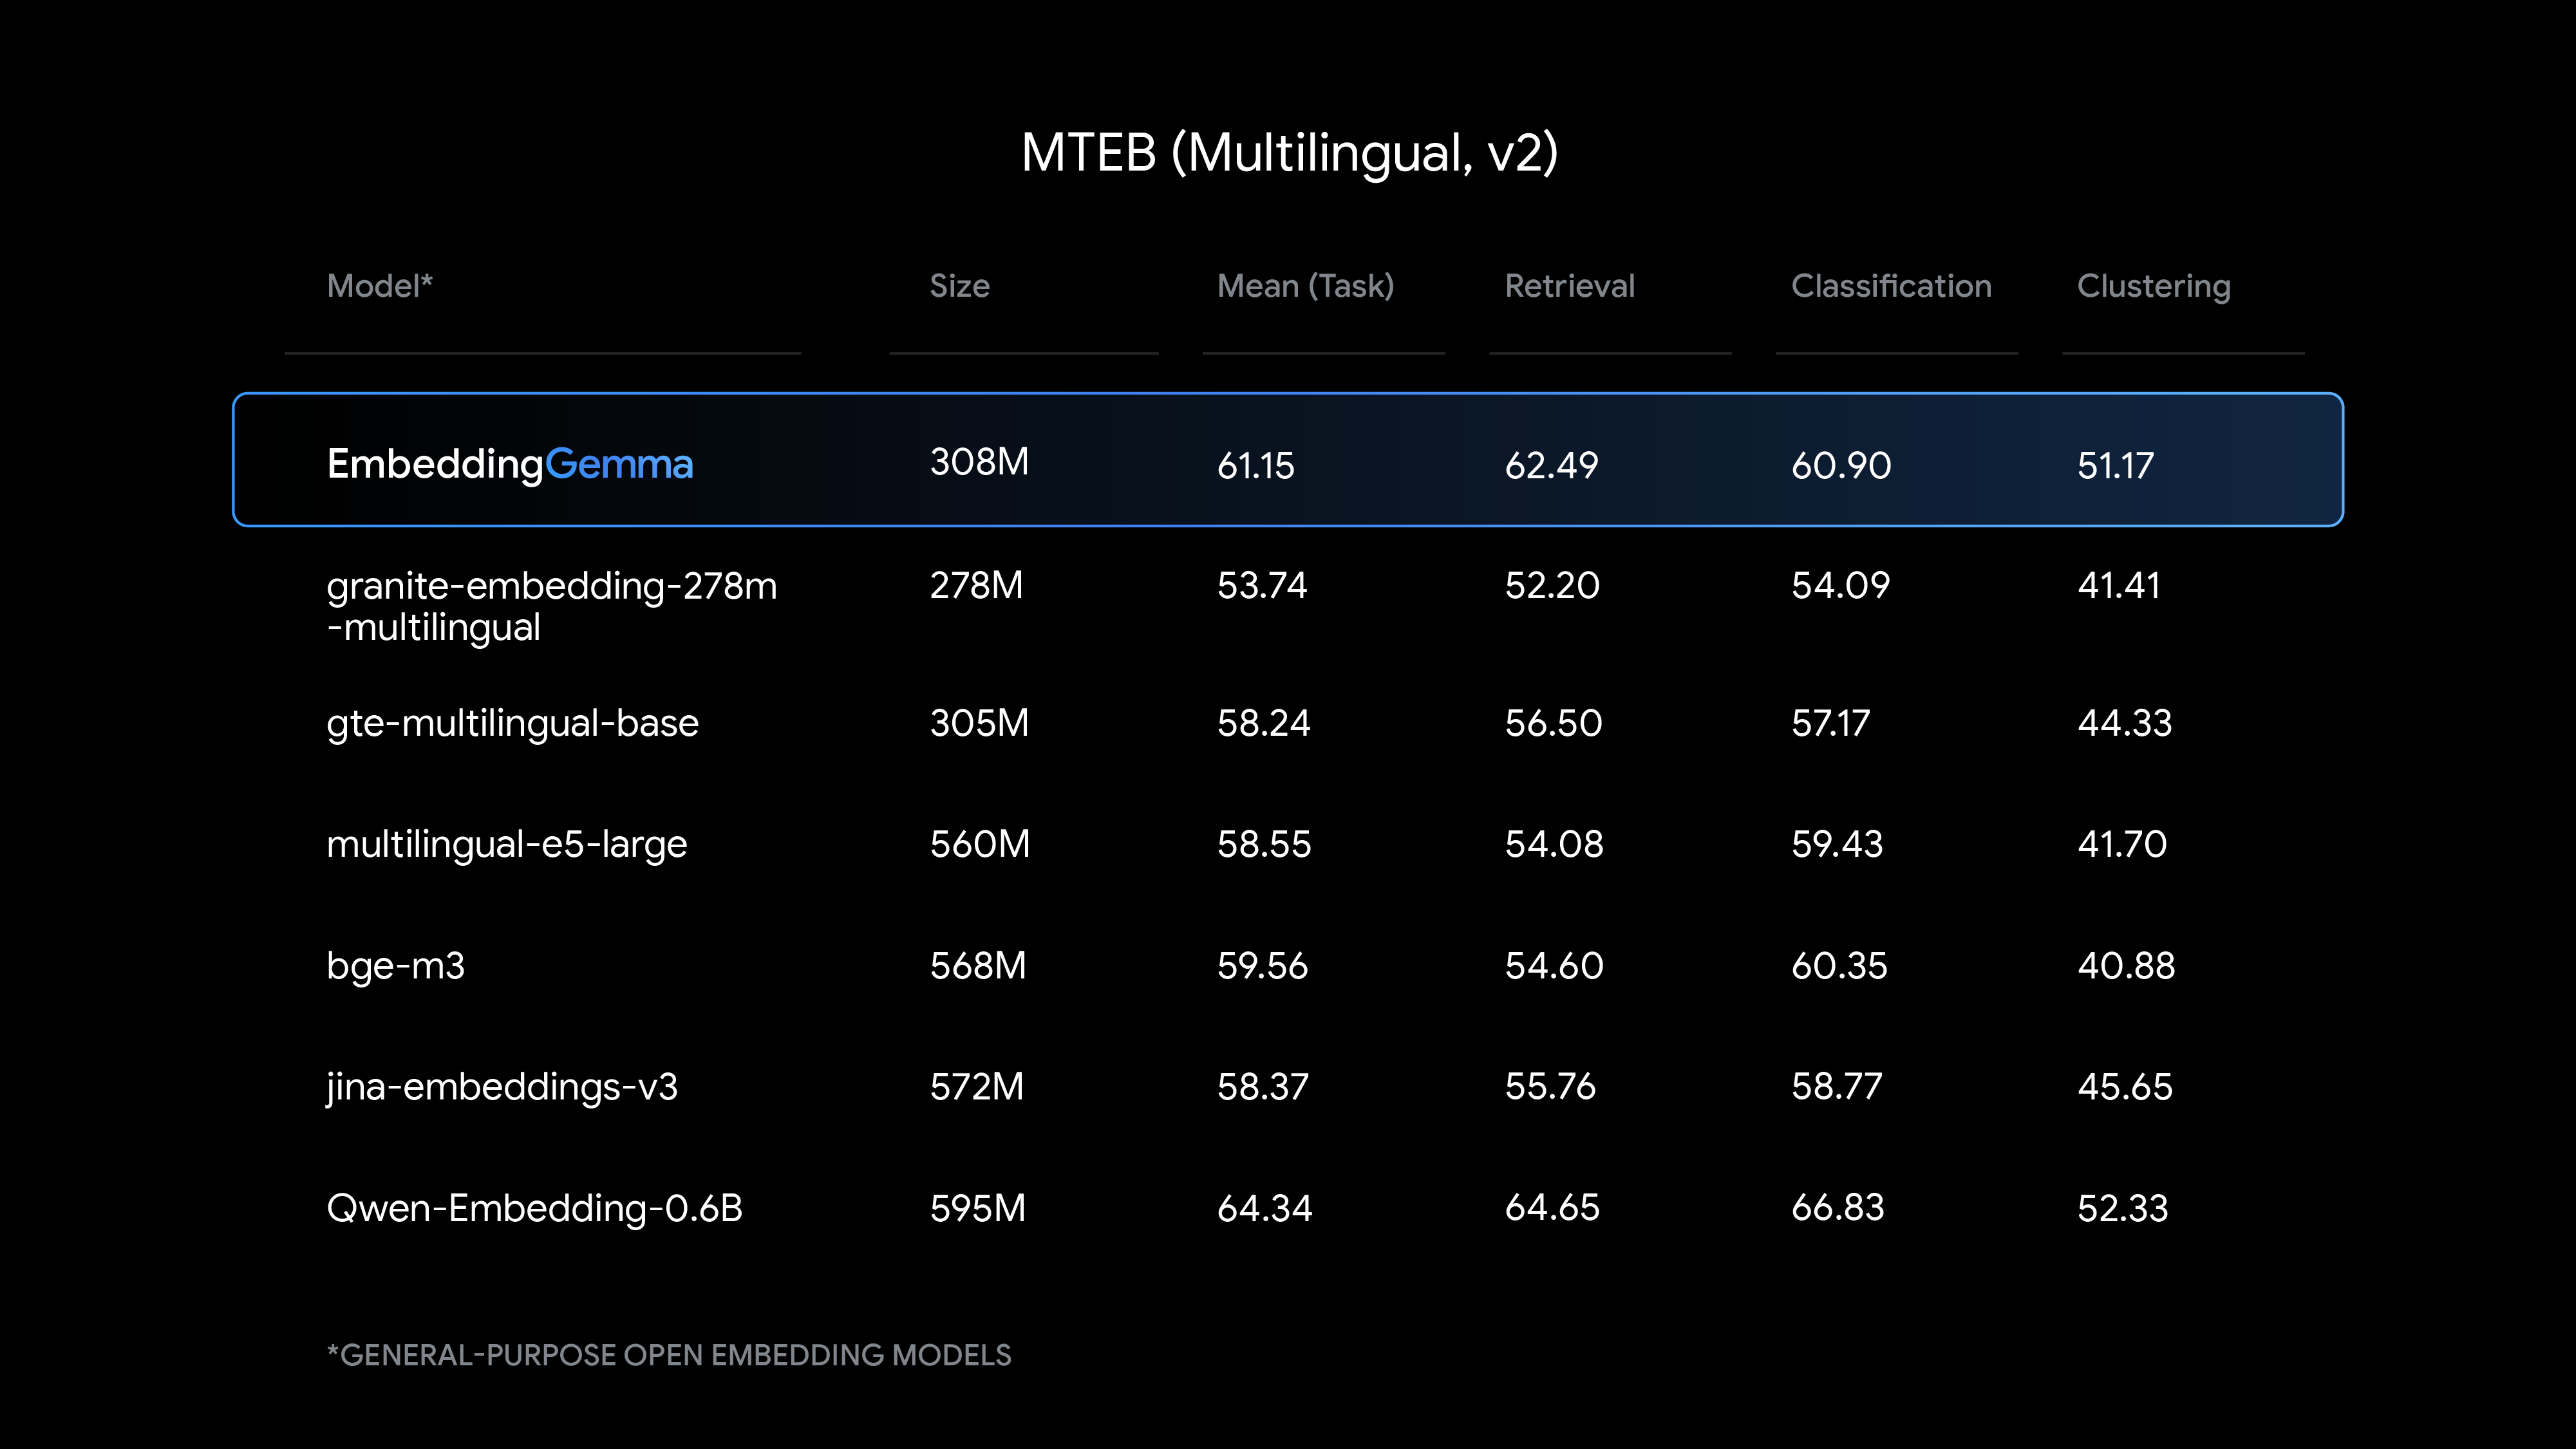
此图表呈现了 MTEB 多语言 v2 评估结果,互补了文章中报告的 MTEB Code 提升,并突显了该模型的多语言能力。