Strata将一款1250亿参数的语言模型带入桌面。该模型为Qwen团队发布的Qwen3.8-Flash-Next,作为下一代Qwen4架构的实验性预览。开源推理引擎Strata(MIT许可)可在配备近期NVIDIA或AMD显卡的游戏PC上运行它,24GB显存卡上速度约每秒100个token,且所有数据均保留在本地。
The opening paragraph introduces Strata as the open-source engine that brings the 125-billion-parameter model to a desktop gaming PC.
该模型规模大但架构特殊。总计1250亿参数,但每次仅激活约60亿参数。它是混合专家(MoE)模型:每层512个专家,共48层,合计约24576个专家,每个词选择10个路由专家加1个共享专家,其余保持休眠。这使得125B模型每步表现更像6B模型,也使其在PC上运行成为可能。
除专家路由外,该模型引入多项架构变更,据Qwen团队称旨在提升大规模效率。Qwen稀疏注意力(QSA)以微块而非单个token处理文本,降低长上下文延迟。门控残差通过数据依赖的读写门调节更宽残差流中的信息。大规模n-gram嵌入表——约510亿参数,按短词序列索引——以少于标准嵌入的计算量扩展参数规模。原生上下文长度为262144个token,可扩展至100万。
Strata的任务是让这一切在专为游戏设计的机器上运行。README使用厨房比喻:常用专家留在台面上,其余在储藏室等待。具体而言,GPU保留最常访问的数千个专家;系统内存存放全部专家;处理器在GPU运行时处理其余专家;SSD存放大型查找表。安装程序选择量化版本的模型——每权重2至4位——因为完整模型无法装入12至24GB显存。
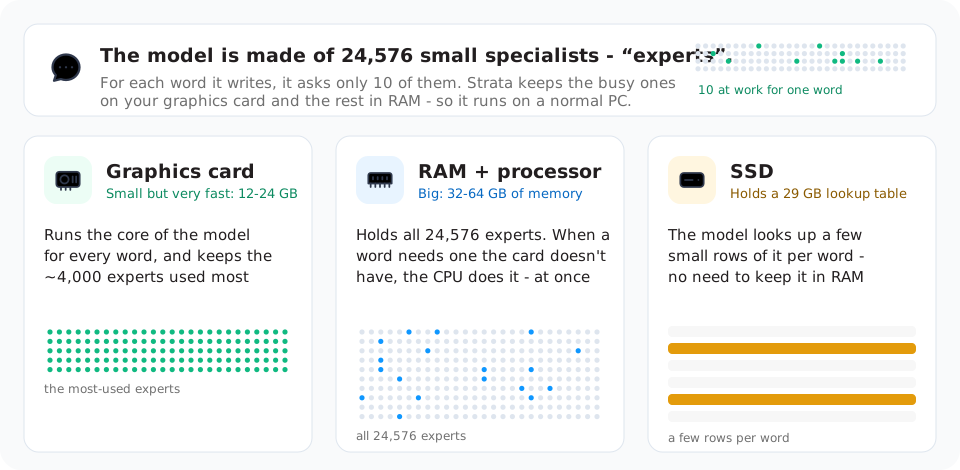
Paragraph four explains the kitchen analogy and the concrete split of experts across GPU, RAM, and SSD that makes the 125B model fit on a gaming machine.
第二项加速技巧提升回复速度。小型辅助模型猜测接下来几个字,大型模型一次性检查全部并保留正确的。README称之为"先猜后查",称其快1.6至1.8倍即可得到相同答案。长提示词以每次最多8192个token的块读取,速度超过每秒1000个token,因此32000token文档约需一分钟摄入。
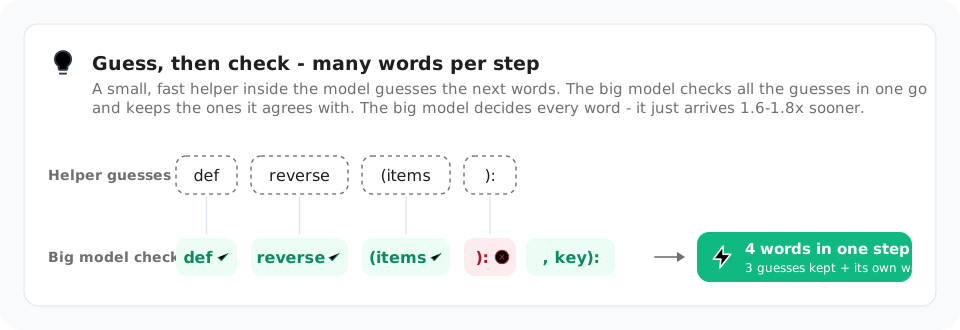
Paragraph five describes the guess-then-check trick that speeds up replies and the README's claim about how much sooner it produces the same answer.
已发布的基准来自两台普通游戏PC,而非标题中的RTX 4090。在NVIDIA RTX 5070(12GB显存、64GB内存、Ryzen 5 7600)上,引擎以每秒94个token的速度生成答案(最激进的Q2_0量化),降至QIQ3_S量化的每秒53个token。读取32000token提示词的速度在1620至2650token每秒之间。在AMD RX 9070 XT(16GB)上,相同量化分别写入60和52token每秒。README指出显存更多的卡更快,估算RTX 3090(24GB)约每秒100至140token——标题引用的量级。一个token约等于三个字,所以每秒100token远超阅读速度。
权衡在于质量,README坦诚说明。较小较快的量化文件在较大尺寸下更智能,安装程序根据机器内存推荐不同量化。Coder变体移除一半专家,达到完整模型SWE-bench Verified分数的91%(作者测量),可运行于32GB内存——但在代码之外较弱,包括中文及其他CJK文本。还有社区微调版本:Swift 1.5版本在回答前思考时间更短,Unsloth的约4位版本位于推荐量化之间,最接近完整的变体在64GB PC上仅写7至8.5token每秒,因为主要从SSD读取。模型在Hugging Face页面上列出的基准分数是Qwen团队在全精度下的测量值——作为未压缩模型能力的参考点,并非对任何特定量化副本的保证。
运行它很简单。安装程序询问使用何种模型大小、保留多少上下文以及是否让模型读取图片,然后下载约70GB并启动引擎。在localhost:8080的浏览器中有聊天界面和模型及GPU、CPU、内存使用情况的实时监控。使用OpenAI兼容API的应用可指向http://127.0.0.1:8080/v1;使用Anthropic API的应用可使用messages端点,让Claude Code等工具将请求路由至本地模型。引擎还提供Responses API,供基于OpenAI较新界面的应用使用。
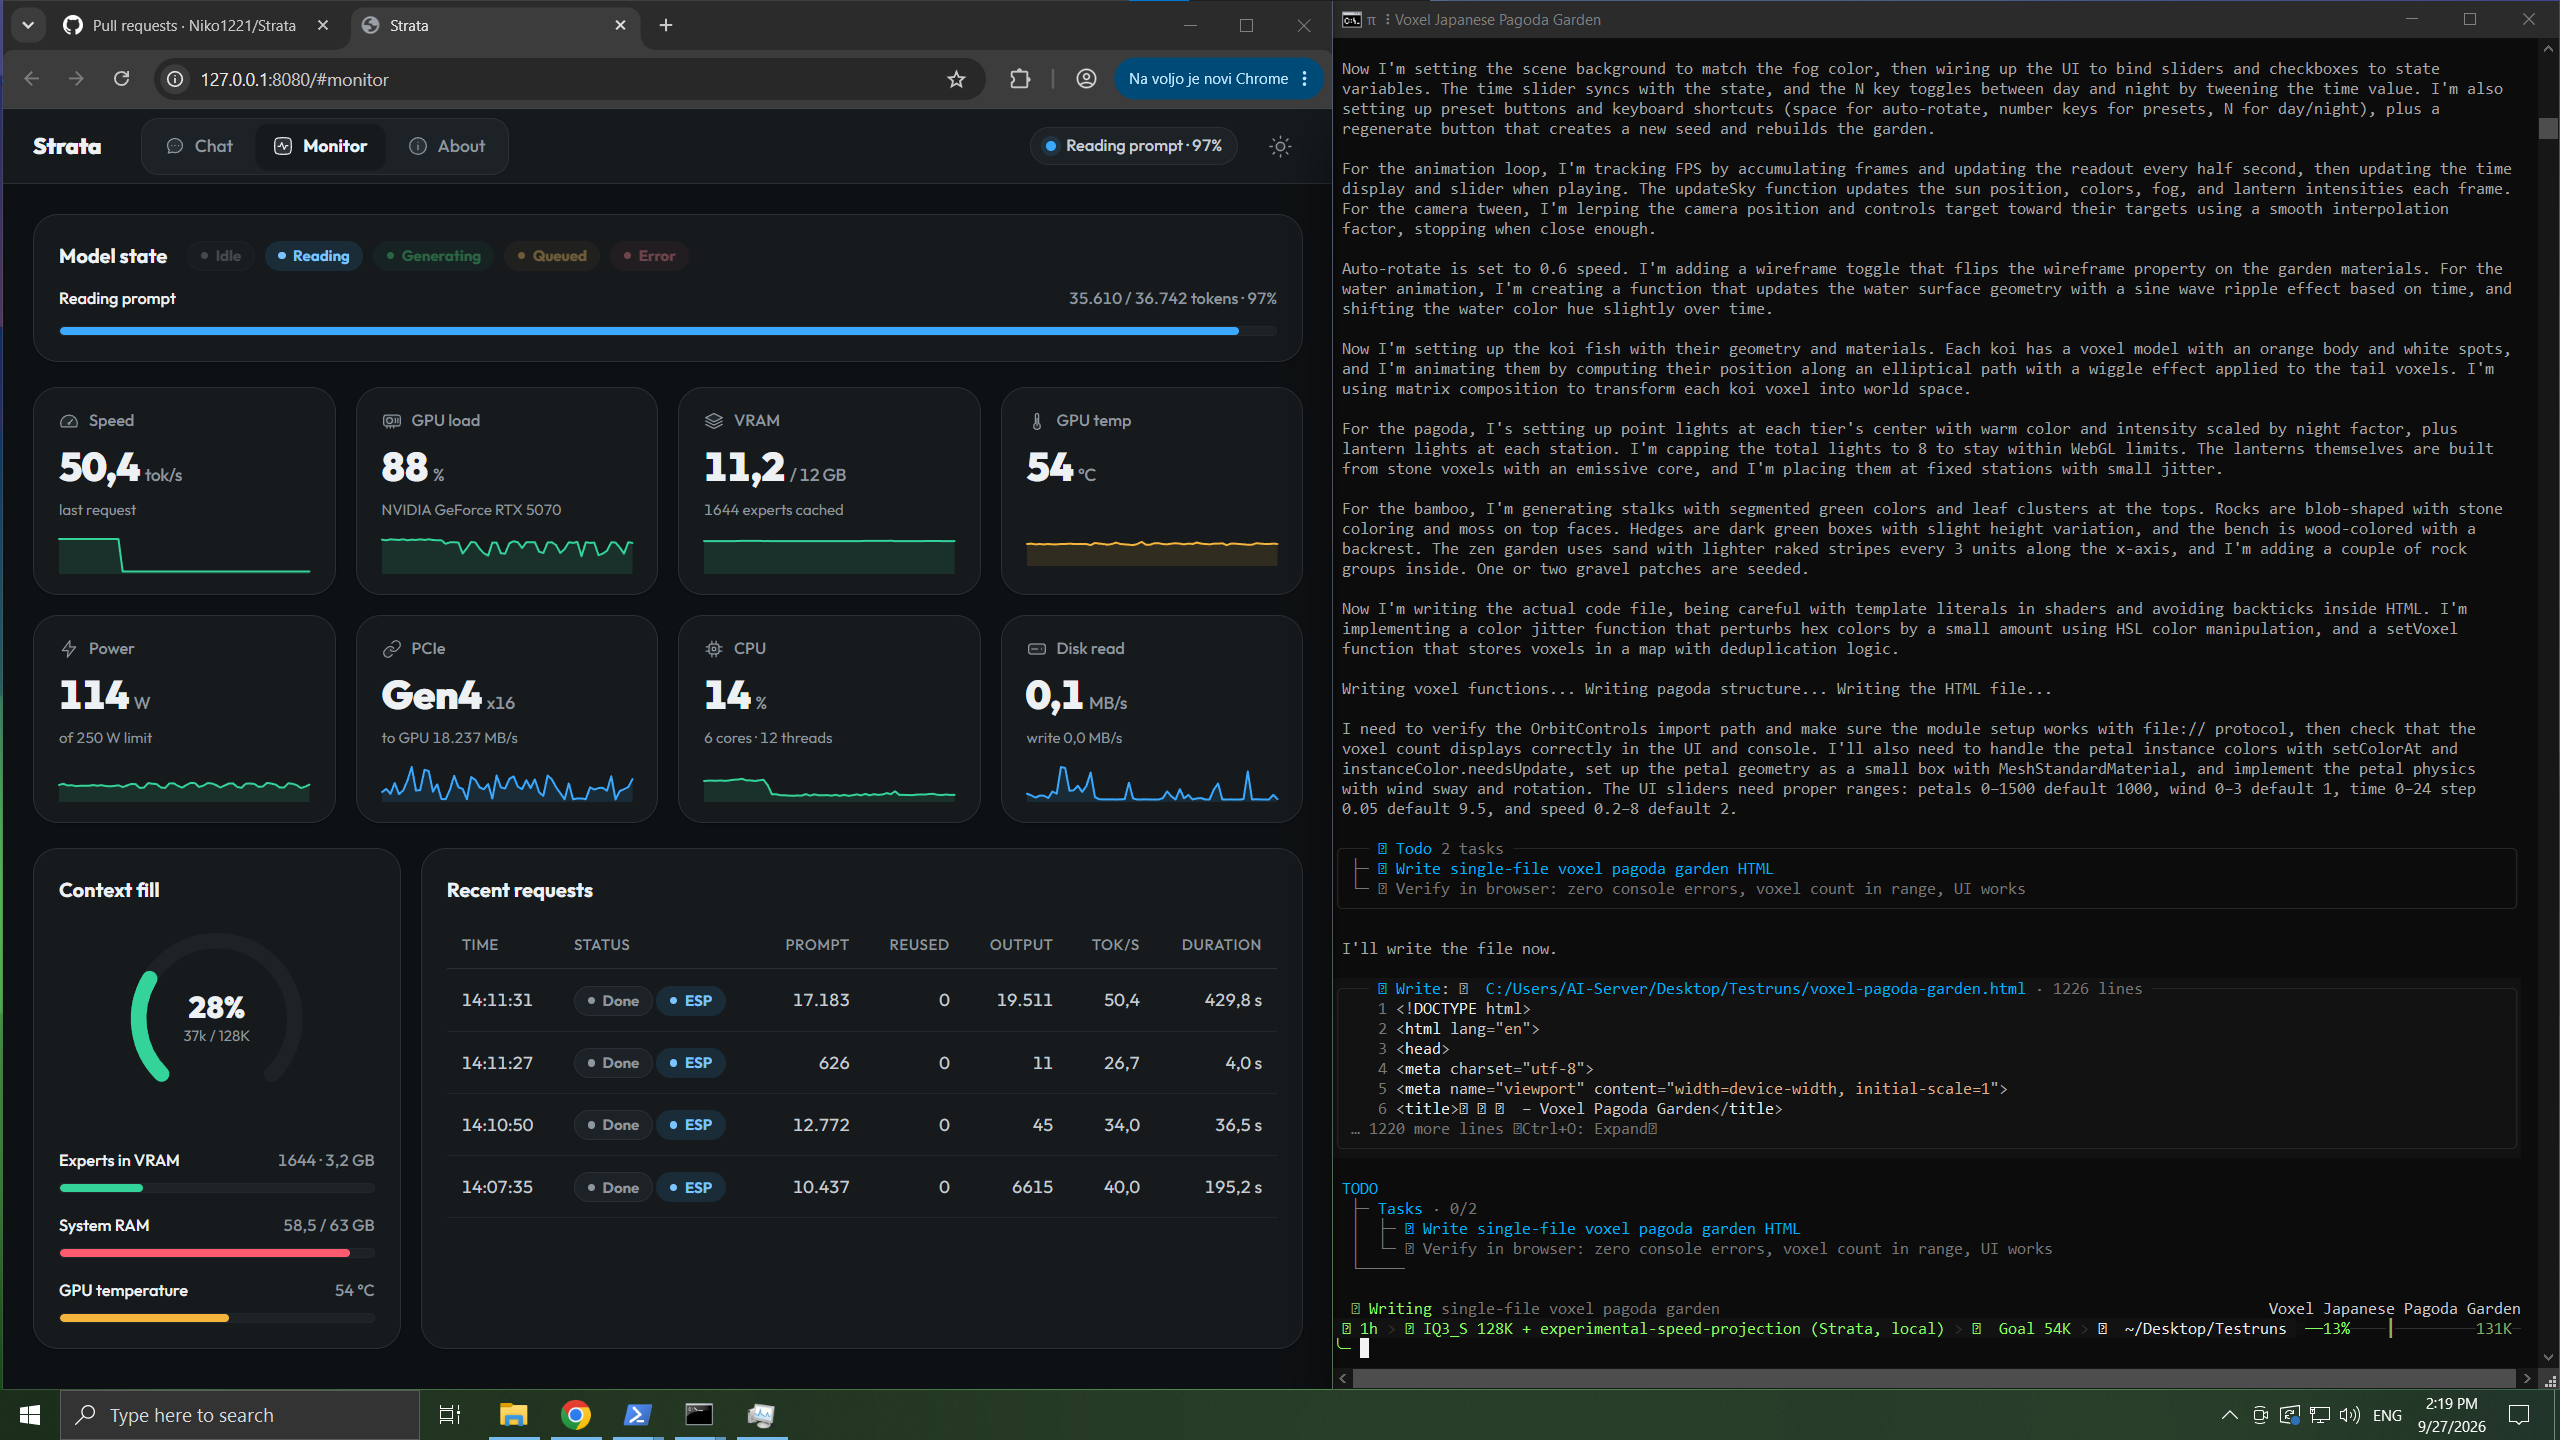
Paragraph eight describes the browser chat interface at localhost:8080 and its live monitor of the model and the machine's GPU, CPU, and RAM usage.
部分吸引力在于,此前需要服务器集群的125B模型现在可在桌面运行,且无数据发送到远程提供商。对于希望获得强大本地模型用于编码、写作或智能体任务,且可能对将代码或文档发送到云服务敏感的开发者与爱好者而言,这是有意义的转变。
注意事项很重要。Strata处于实验阶段,README警告首次启动时机器可能冻结一至三分钟以将模型加载到内存中,这是正常现象。引擎默认一次处理一个请求,但可配置为多个并发流。图片输入在大多数设置上可用,但AMD卡目前仅能在Linux(而非Windows)上读取图片。速度数据来自特定引擎版本在特定硬件上的表现——已发布表格的大多数行使用引擎0.1.26,最快Q2_0行使用0.1.36——实际数字会因显卡、量化大小和提示词而异。
仍不确定的是较低位量化在实践中的表现,以及标题中RTX 4090上约每秒100token的速度是否与引擎对可比24GB卡的估算相符。RTX 3090数据是估算而非基准,已发布表格来自不同显卡。确认该数字需要在确切配置上进行独立测试。