在 2026 年 9 月,基于 Python 的内容管理系统 Wagtail CMS 的团队发起了一项他们称之为“仅限开放模型:返校挑战”的实验。目标看似简单:在整个 9 月份仅使用一种高效的开放模型层进行编程,即 GLM 5.3 Flash。正如团队所解释的,“在当时,设定一个在整个 9 月份仅使用一种高效开放模型的挑战感觉是个很棒的主意。”
所选模型是 GLM 5.3 Flash,它是高效开源 AI 模型的一个层级。根据 Wagtail 博客的介绍,GLM 5.3 Flash 拥有 100 万的上下文窗口,能够支持长程编程任务和复杂的推理。它还提供视觉支持,意味着它可以处理截图或视觉问答。该模型可在广泛的供应商中获取,受益于良性的竞争。这些技术优势使其非常适合团队为自己设定的挑战。
这个月进展顺利的地方有哪些?团队成功在 9 月的前半月仅使用 GLM 5.3 Flash。该模型的消耗远低于预算:成本约为 68 美元,耗电约 4 kWh,碳排放量为 365 克。为了更直观地说明,团队指出这种能耗相当于驾驶电动汽车约 15 英里或烧开 10 加仑水。GLM 5.3 Flash 本身在团队需要的任务中表现出色:包括使用 Wagtail 构建站点、UI 任务、AI 研究与开发工作、文档编写以及代码评估。该模型的通用性使其在他们的工作流中变得“非常多功能”。
然而,这个月后半段的发展并不符合预期。大约 10 亿个 Token 被用于其他模型,导致总 Token 使用量达到 20 亿,而非目标中的 10 亿。累计能耗约为 35 kWh,而非预期的 10 kWh。团队识别出了几个意料之外的障碍。
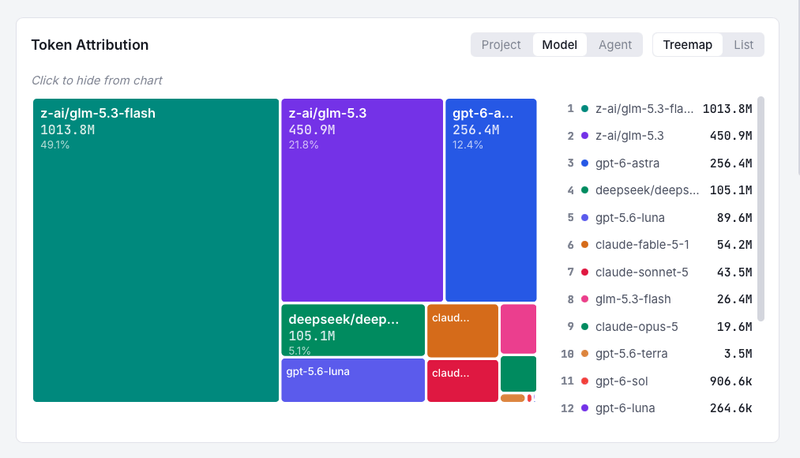
实验关键发现的视觉呈现:只有 50% 的 Token 用于目标模型,另一半用于其他模型
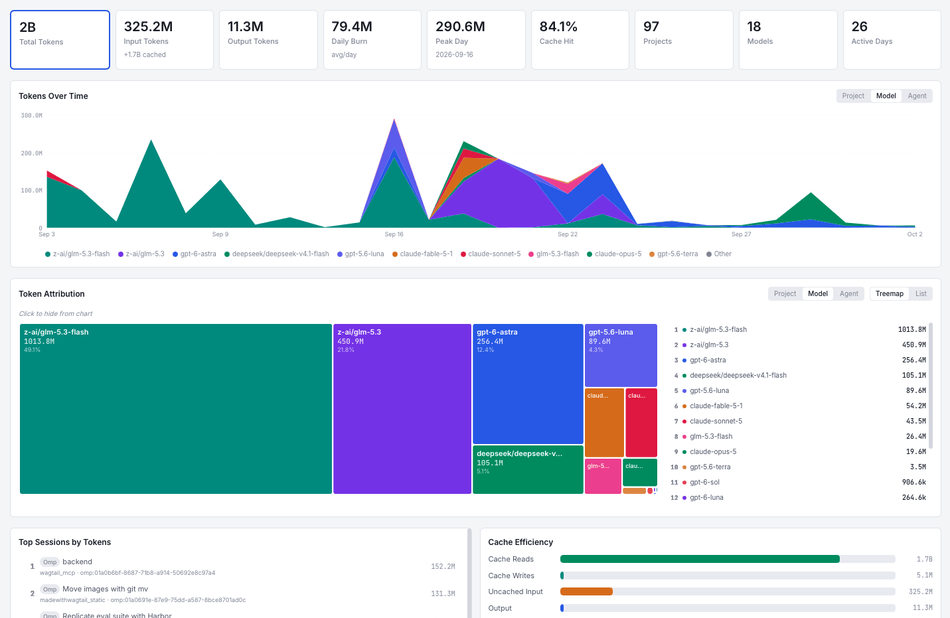
显示超出 10 亿目标的总 Token 消耗的截图,说明了超出的规模
一个显著问题是团队所称的“氛围编程(vibe coding)的成本”。他们实验性的 Wagtail MCP 服务器——一个氛围编程原型——在原型用途上使用了“错误”的模型。他们选择的模型导致几乎一夜之间消耗了 4.5 亿个 Token / 150 美元 / 5 kWh 的能耗。团队承认这是一个原型错误:“我们本可以用大约 5 倍更低的成本实现类似的结果,且不需要付出太多额外的努力。”教训是:要谨慎选择模型和代理模式。他们需要为此预留预算并更加小心;他们本可以预见到这一点,但现在他们知道了。
另一个障碍是基础设施的可用性。团队曾广泛撰写过关于比较推理供应商的内容。他们的选择在大多数情况下运行良好,但这些模型非常受欢迎,且它们不具备那些囤积所有 GPU 的大型实验室那样的容量。对于他们的情况,由于只有开放模型被确认可在欧洲数据中心提供,GLM 5.3 Flash 的性能下降可能是因为它“处于我们工作相关模型帕累托前沿(Pareto frontier)的极高位置”。当 GLM 5.3 Flash 表现不佳时,团队不得不切换到其他类似模型:DeepSeek V4.1 Flash 和 Qwen 3.8 Flash。这次切换“操作非常简单,但并非意料之中”。
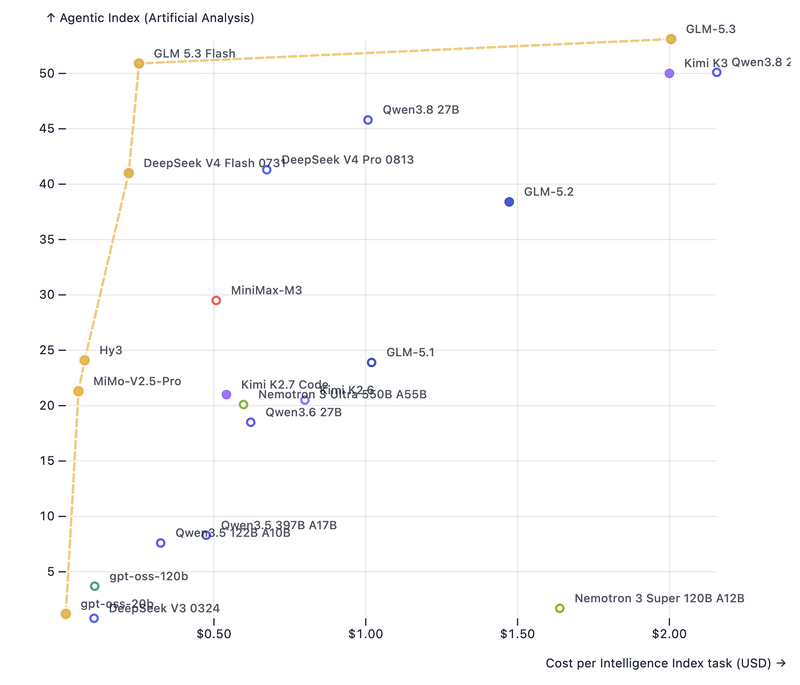
文章中讨论的模型选择挑战的图形说明,其中像 GLM 5.3 Flash 这样的高性能模型位于帕累托前沿
除了在日常工程中使用单一模型外,团队认为持续实验各种模型以跟上供应商发布的新动态是至关重要的。随着他们开始基准测试模型在 Wagtail 任务上的表现,他们需要涵盖广泛模型的数据。团队分享了他们基准测试的预览,并指出“有了这类具体数据,引导人们转向更精简的选项要容易得多”。
团队的总结和下一步计划非常明确。从技术上讲,这次挑战失败了:目标模型的占用率仅为 50%,即 20 亿 Token 中的 10 亿。能耗约为 35 kWh,而非 10。但他们学到了很多,团队认为这对于当前时刻至关重要。反思 10 月份的计划,以下内容将使其成功: - 持续的本地使用测量和报告。不仅关注 Token,还要关注能耗和支出,理想情况下还要关注这些如何转化为具体的积极成果。 - 为实验预留预算,而不仅仅是日常任务。对哪些原型值得构建以及如何构建做出更周密的决策。 - 更好的提示词选择和多代理技术。编排者 vs. 侦察员 vs. 执行者 vs. 审核者代理。限定目标。这不是火箭科学,但确实是需要学习的额外内容。 - 继续推动更高效的技术和模型。如果 Jev 式的决策扩散模型能够如此高效地运行,它们看起来非常有前景。最新的旗舰模型在这一方面似乎也是朝着正确方向迈出了一步。
对于日常开发工作,团队得出结论:专注于一到两个闪速层(flash-tier)的廉价模型是完全可行的。一个可行的目标可能是:大部分 AI 推理工作应该使用此类高效模型完成,衡量标准是成本或能耗,而非毫无意义的 Token 数量。这是 10 月份的目标——他们鼓励其他人也去尝试,因为在过程中他们将学到很多。他们将于 11 月参加 Wagtail Space 2026,届时将听取所有进展。
这次实验反映了 AI 开发理念的重大转变。团队认为,大部分 AI 推理工作应转向高效模型,衡量标准是成本或能源,而非毫无意义的 Token 计数。这一经验表明了一种新范式:不是取代 Claude Opus 等强大模型,而是将高效模型作为常规任务的“主力军”,同时将高端模型保留给复杂的、新颖的挑战。
展望未来,Wagtail 团队计划在 10 月份实施这些教训,旨在实现更高效的 AI 使用模式。他们指出,当前时刻是建立更好实践的关键机会,因为这些高效模型在竞争力和需求上将变得与它们目前所取代的前沿模型一样强劲。这次实验在技术上被视为部分失败——目标模型仅占 50% 的使用量——但它为更广泛的 AI 开发社区提供了至关重要的学习经验。
] ,