如今的 AI 代理经常依赖于试图在会话间提供持续上下文的 'memory' 插件。然而,这些系统在根本上是有缺陷的。这些插件并未帮助代理解项目,而是制造了一种彩票:代理检索过去对话的片段,希望相关的片段能浮到顶部。 问题在于这些记忆系统的架构。几乎所有商业记忆插件的工作方式相同:它们分析会话转录,生成记忆片段,存储在向量数据库(RAG)中,并在每次提示时检索最相似的前 5 个片段注入到代理的上下文中。这种方法存在若干关键限制。 首先,记忆仅通过嵌入空间的相似性浮现,没有机制来判断哪个片段是正确的、当前的或完整的。其次,仅存储片段会丢失关键上下文——动机、吸取的教训、环境因素以及决策背后的推理。第三,这些系统将过去视为真理,却忽略代码库每日演进,导致有关身份验证等功能的片段很快过时。第四,即使赋予代理在其记忆上进行搜索的工具,他们也不知道应搜索什么,因为他们不知道自己不知道什么。最后,记忆存储变得不可审计——SQLite 中有数千个嵌入向量,无法核实哪些记忆存在,哪些已过时,或者哪些可能错误地影响了代理行为。 核心洞察在于,代理不需要更好的召回机制,他们需要文档。正如作者所观察到的:‘没有人会重温三年前的团队会议来记住某个功能的约束。人们会把事情写下来并使用这些记录。’ 这一认识促成了基于文档的记忆系统的开发。这些系统不是捕获易逝的对话片段,而是为代理提供一个结构化的 Markdown 文件工作区,以便他们持久化重要知识:规格、决策、研究发现、索引和指南。代理循环由此从 'prompt → build → forget' 转变为 'prompt → consult → build → update'——在开始工作前,代理会从其‘大脑’中查阅相关文档;工作完成后,通过修订过时信息并根据需要添加新文档来更新大脑。 这种方法的一种实现是 Operator Memory,它为代理提供了一个基于 Markdown 的‘大脑’,分为三个分区:私有项目知识(.operator/)、与仓库共享的项目知识(.operator-shared/)以及可跨项目使用的个人规则(~/.operator/user/)。该系统具备规格和决策的自动文档化、以可读 Markdown 文件形式存储的透明记忆、通过 Git 版本控制共享知识,以及零基础设施需求——无需后台代理、嵌入或向量数据库。 类似的原则也出现在诸如 Encephalon 之类的替代系统中,它将持久的代理知识存储为可 Git 合并的 JSON 记录,并通过 SQLite 索引以实现快速搜索。两种方法共享的关键特征是将代理记忆视为可读取、可更新、可提交和可共享的文档,而非不透明的召回机制。 这一转变代表了我们思考代理状态方式的根本变化:从脆弱且缺乏上下文的片段转变为可维护、可审计且能随着项目和团队成长的文档.
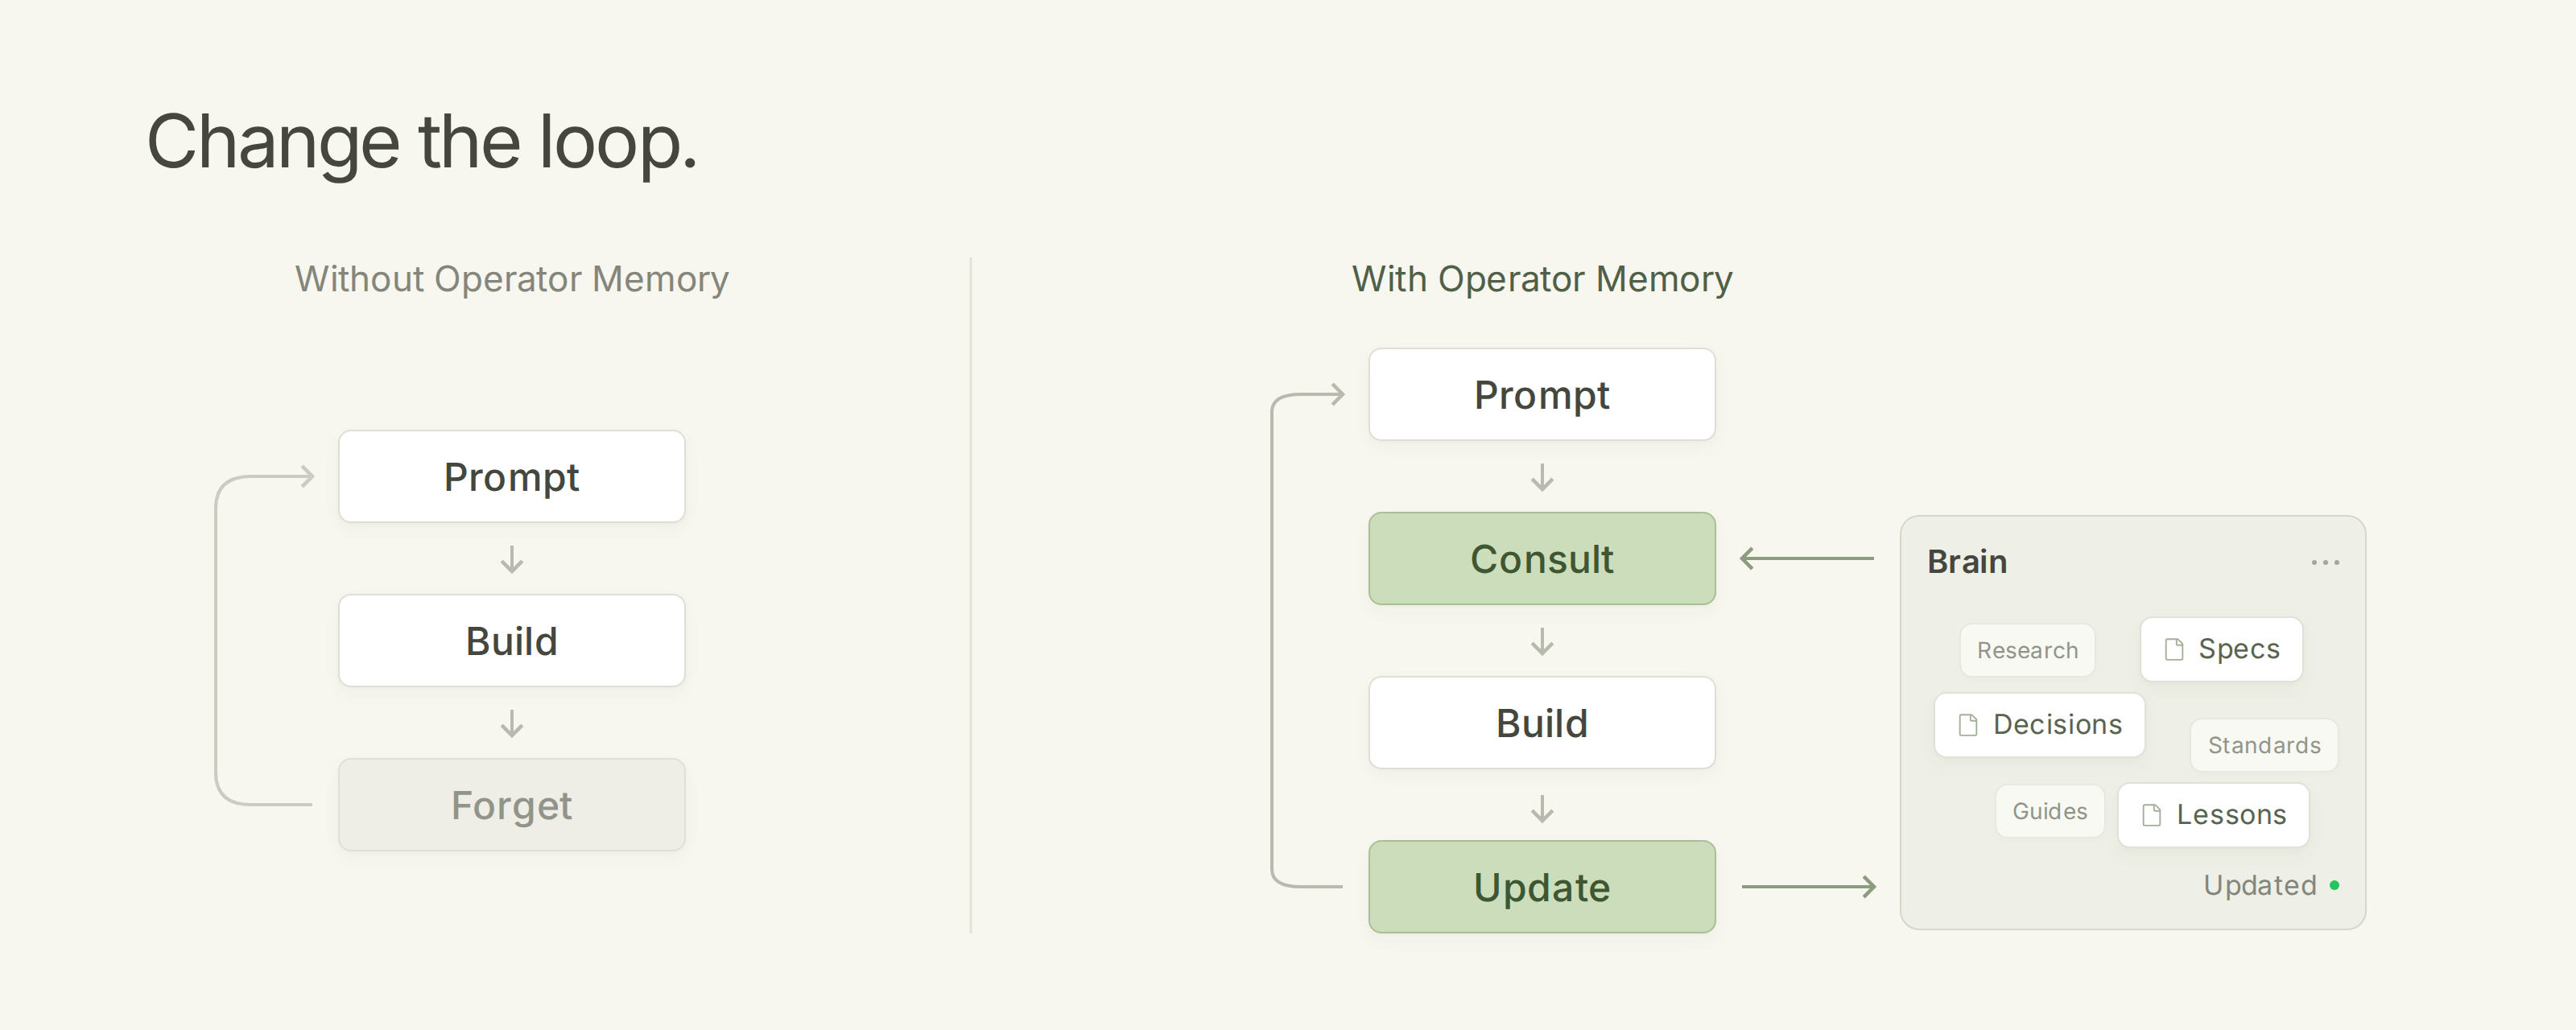
The image supports the article’s core argument that agents should consult documentation (the brain) before building and update it after work, rather than relying on unreliable memory snippets.