TypeSafe的Jev等决策模型被提出作为AI安全防护的折中方案,旨在结合传统分类器的结构化、类型安全输出以及大语言模型的零射击灵活性。通过返回固定决策(例如概率)而非生成文本,Jev声称能够提供更快、更经济的推理,同时规避传统文本分类器所需的特定任务训练数据。
Red Hat AI安全团队进行的基准测试测量了提示注入和内容安全防护的延迟和准确率。在提示注入检测中,Jev的准确率为86.35%,中位延迟为348.1毫秒;而传统的deberta‑v3‑base‑prompt‑injection‑v2分类器准确率为89.01%,延迟为54.1毫秒;Qwen3.6‑35B LLM‑as‑a‑judge模型准确率为89.31%,延迟为312.5毫秒。在毒性/粗俗安全测试中,Jev准确率为86.20%,延迟为360.4毫秒;而granite‑guardian‑hap‑125m传统分类器准确率为80.27%,延迟为33.2毫秒;Qwen3.6‑35B准确率为85.47%,延迟为307.6毫秒。将Jev与其他LLM‑as‑a‑judge选项(如Shieldstral‑1.0和Nemotron‑3.5变体)进行比较时,也出现了类似的延迟差距。
此图像展示了Red Hat AI标志,代表进行了文中提到的决策模型和传统分类器基准测试的组织。
这些结果表明,Jev未能兑现其速度优势的承诺;其延迟大约是传统分类器的六倍,比领先的LLM‑as‑a‑judge模型高10‑20%。尽管Jev的准确率仍具有竞争力,其零射击能力在无需训练数据的新颖防护场景中可能有用,但额外的决策延迟在高吞吐量AI应用中可能超过其模式安全优势,因为这些应用期望毫秒级响应时间。因此,采用者应根据具体的延迟要求评估Jev,而不应仅凭其假设的效率优势。
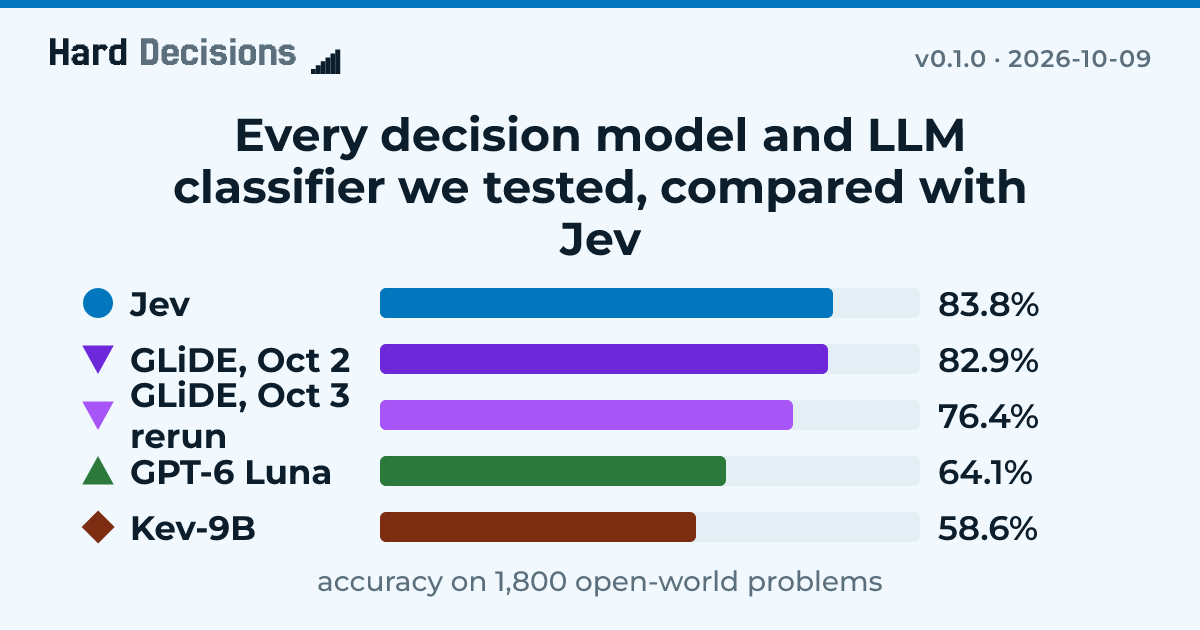
该图表显示Jev的准确率为83.8%,低于GLiDE,高于GPT-6 Luna和Kev-9B,说明了文中讨论的准确率与延迟之间的权衡。