Gemini 4 Argon 是 Google 最新的前沿 AI 模型,通过公司官方博客宣布。该模型提供业界领先的 100 万 token 上限(输入和输出均如此),使得在长跨度工作流中能够进行深度多步骤推理。目前,该模型正通过 Fairwind 计划向受信任的网络防御者推出,更广泛的发布将在安全测试和防护措施完善后进行。
性能评估显示,Gemini 4 Argon 在 DeepSWE v1.1 上达到新的州-of-the-art 77.9% 分数(用于真实世界的软件工程任务),并在 Vals Index、Vals Finance Agent v2、Harvey's Legal Agent Benchmark 以及 AutomationBench 上取得领先成绩(在 AutomationBench 中排名第一,得分 51.3%)。在内部,该模型在分钟级别内将量子算法时空资源优化了 40%,在谷歌数据中心中发现节省超过 300 TiB 的内存,并正在将 C/C++ 代码库迁移到 Rust——包括 Fuchsia Zircon 内核的 800K+ 行代码,以及将 libgav1 中的 32K 行 SIMD 替换为安全的 Rust,从而使视频解码器的速度提升 2.7 倍。
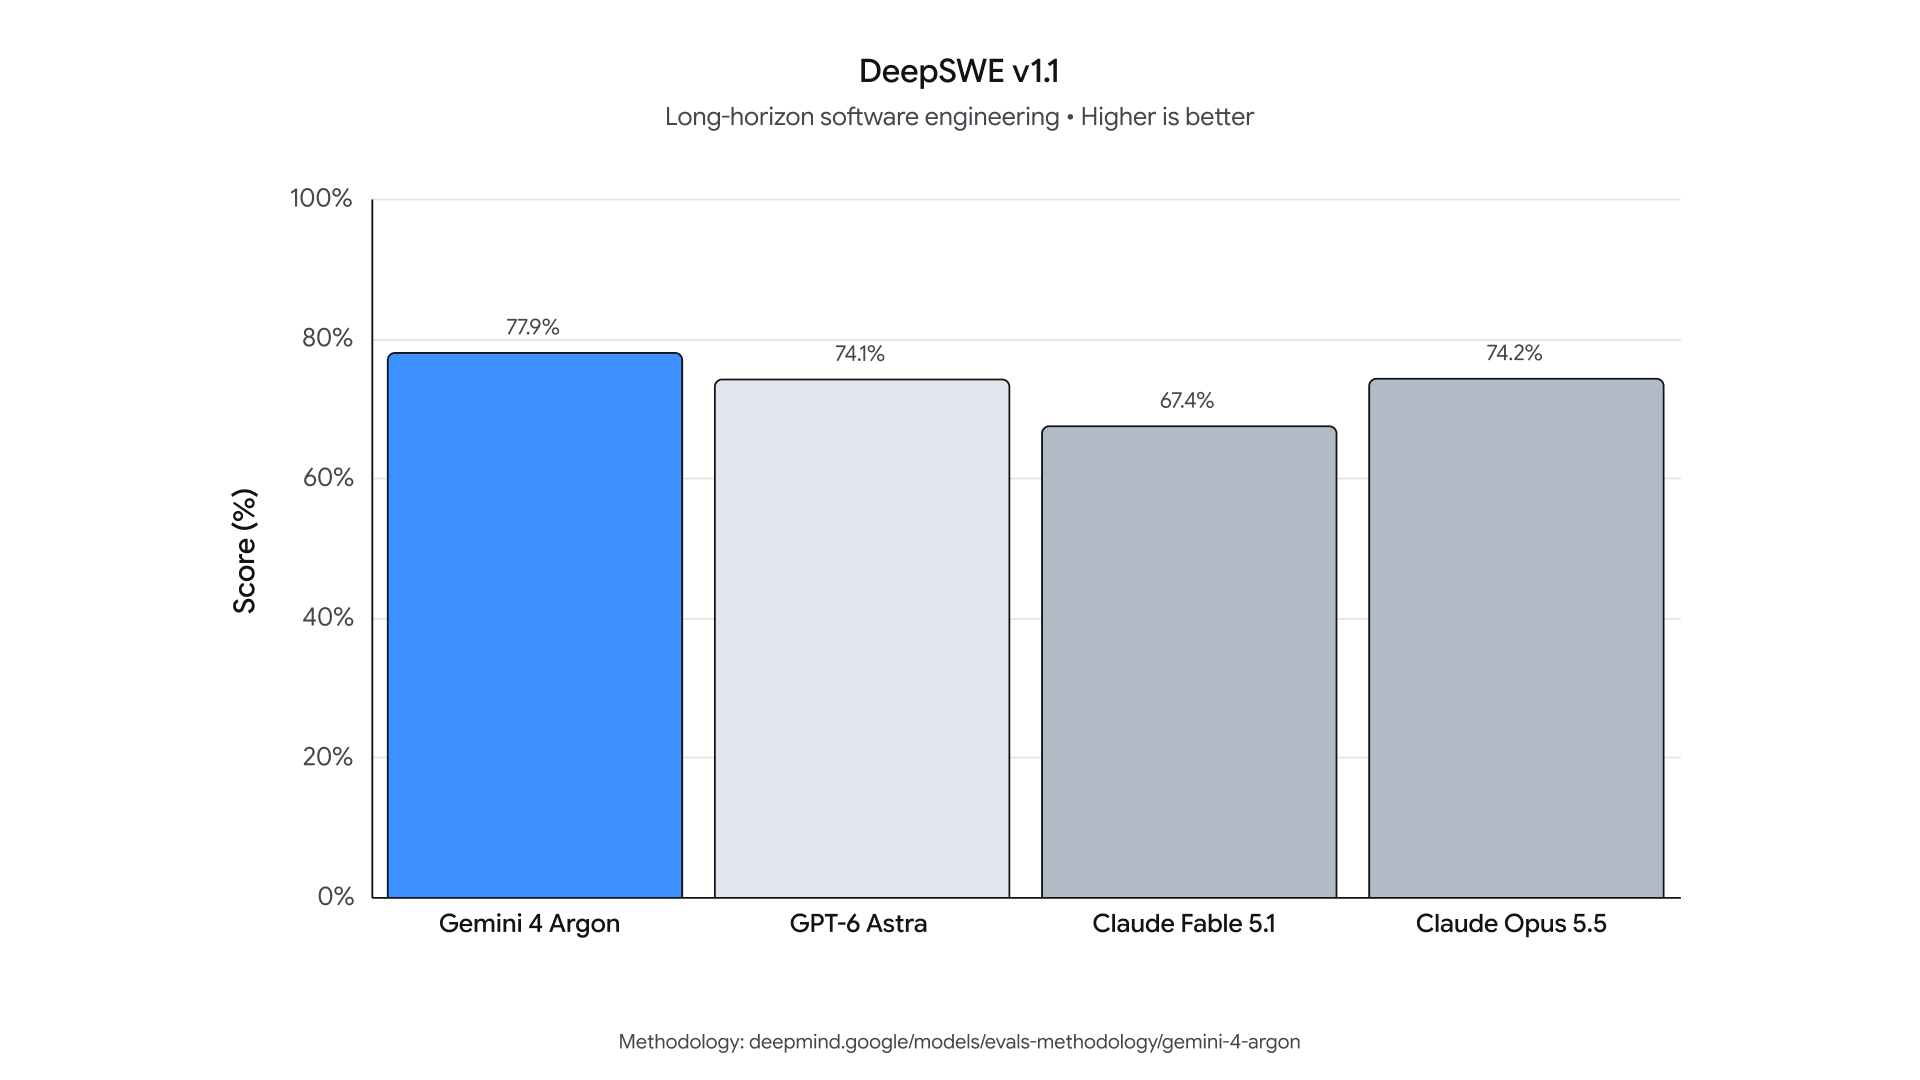
文章引用 Gemini 4 Argon 在 DeepSWE v1.1 上的表现作为州-of-the-art 结果,表明其在软件工程推理方面的优势。

文章指出 Gemini 4 Argon 在 Vals Index 基准测试中取得领先得分,高于其他基准测试。

文章提到 Harvey's Legal Agent Benchmark 是 Gemini 4 Argon 取得领先得分的基准测试之一。
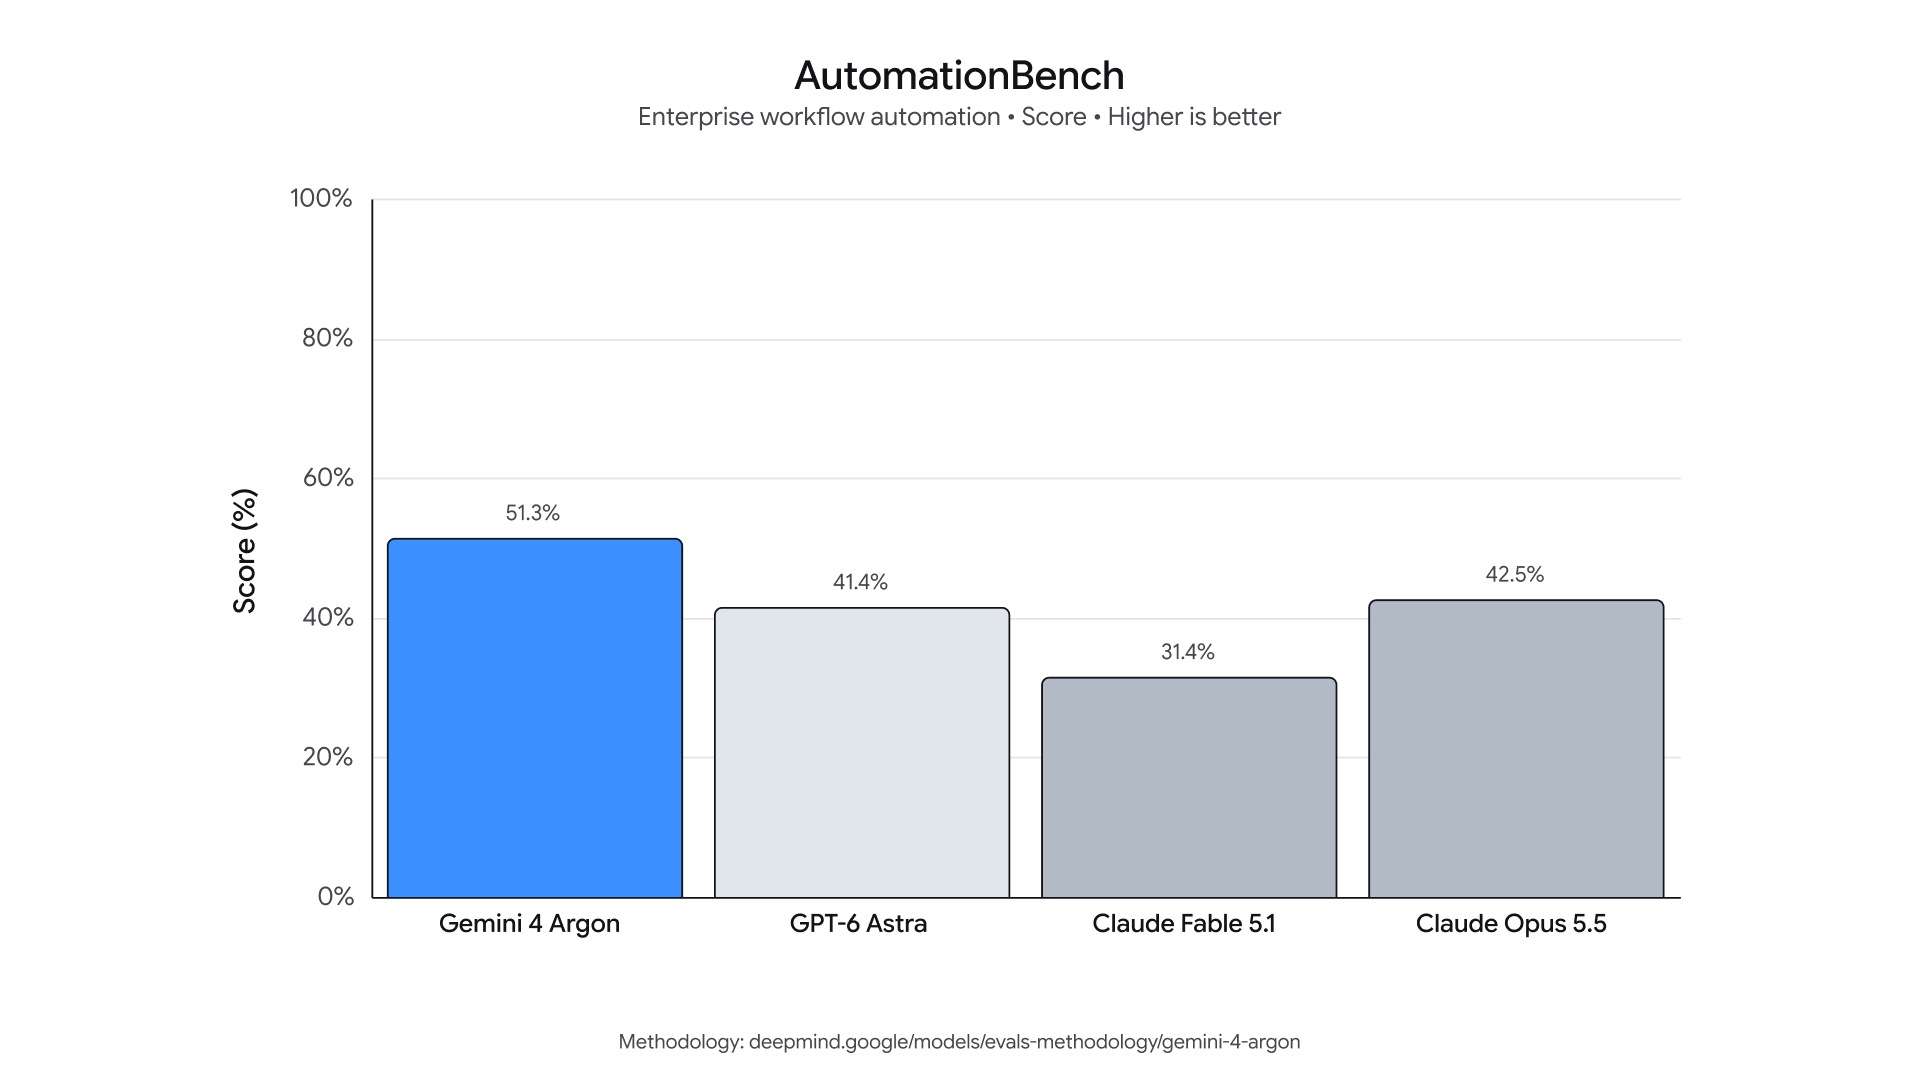
文章说明 Gemini 4 Argon 在 AutomationBench 中排名第一,得分 51.3%,凸显其自动化能力。
在网络安全领域,Gemini 4 Argon 能够自主发现、验证并修补关键软件漏洞,在 CWE-bench v1 上以 68% 的分数并列第一。Wiz 通过其 Scan for Good 计划使用该模型,发现了全球医院使用的医疗软件中暴露个人信息的关键漏洞。安全措施包括 Frontier Safety Framework,通过监控内部激活来检测滥用,利用对抗训练提升防注入鲁棒性,通过监控思维链来缩小错位风险,以及采用强化沙盒环境以进行安全测试。