Cactus 发布了 Needle 3,这是一个“自动化基础模型”,旨在微型设备——手机、穿戴设备、智能家居中枢、机器人和微控制器——上运行工具调用、结构化数据抽取和文本搜索。整个模型作为一个单一的 8–29 MB 二进制文件分发,量化至约每权重 2 比特,公司的核心宣称是:一个小型、经过微调的切片能在调用工具和从文本中提取结构化字段这两项特定任务上,媲美云端托管的、大得多的前沿模型 DeepSeek V4 Flash。
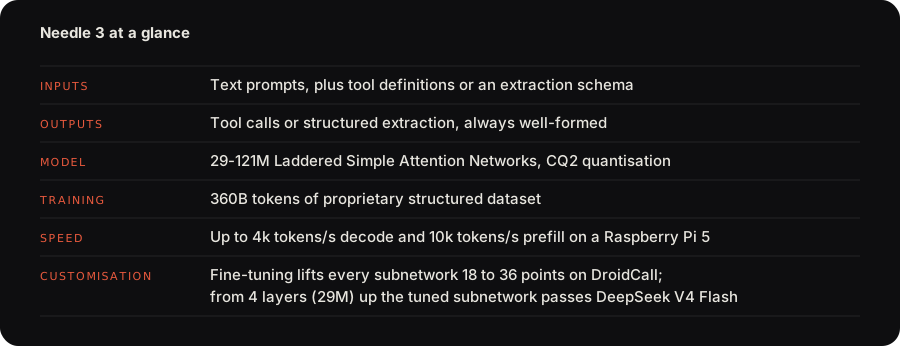
文章解释 Laddered Simple Attention Network 用 Monarch Hadamard MLP 取代标准前馈网络,将 GQA 与因果卷积配对,并通过聚集操作读取 engram n-gram 记忆。
设计中不同寻常的部分是 Cactus 所谓的“智能阶梯”。Needle 3 是一组权重,但从 2 层到 20 层的每一个深度本身都是一个可部署的模型。开发者可以发布完整的 20 层版本,也可以为树莓派部署 8 层子网络,且每个子网络都可以独立微调。根据公司自家的基准测试,一个在下游任务上微调一个轮次的 4 层子网络能媲美 DeepSeek V4 Flash,该模型在移动端工具调用任务上击败体量约为其 10 倍的模型,在抽取任务上媲美体量为其 2 到 3 倍的模型。
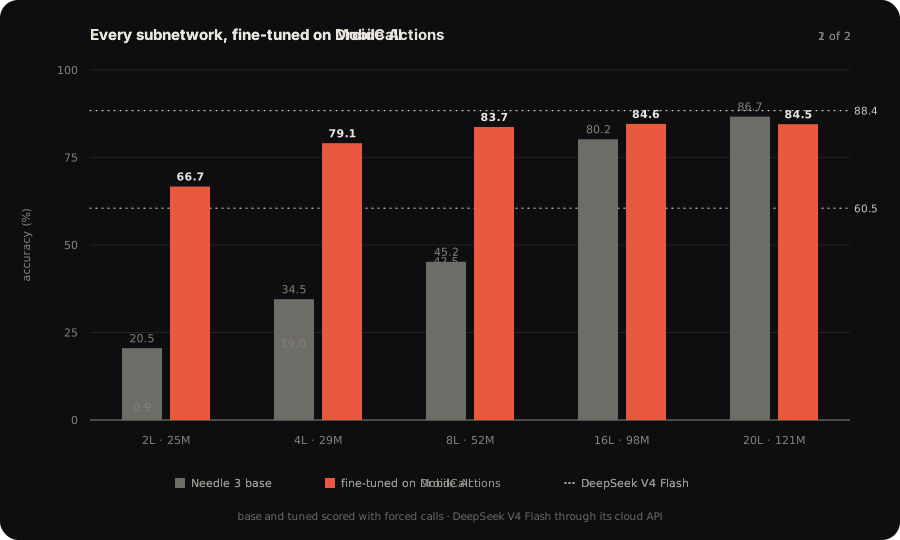
文章描述智能阶梯中从 2 到 20 层的每个深度都是可部署模型并可独立微调,且 4 层子网络微调一个轮次后媲美 DeepSeek V4 Flash。
一个 8–29 MB 的模型如何尝试做到这一点?答案在于 Laddered Simple Attention Network,这是一种架构,旨在使每个 token 的计算量远少于同等规模的 Transformer。根据 GitHub 仓库,它用 Monarch Hadamard MLP 取代了标准的前馈网络(FFN),将分组查询注意力(GQA)与因果卷积配对,通过聚集操作读取“engram” n-gram 记忆,并添加多通道超连接。模型的大部分参数都位于该 engram 中,因此公司称这款 1.21 亿参数的模型只做相当于 5000 万参数模型的算术量。产品页面补充说,该架构每个 token 的百万浮点运算(MFLOPs)比同配置的 Transformer 少 2 倍以上。该模型在 3600 亿 token 的专有结构化数据集上训练,在树莓派 5 上解码速度为 400–4,000 token/秒,预填充速度为 1,000–10,000 token/秒。
Needle 3 面向三项窄域能力而非对话构建。给定应用暴露的函数,它会挑选正确的工具并从用户所说的内容中填充每个参数:若要求做两件事,它按顺序返回两次调用;若要求的事没有工具覆盖,它返回空列表而非猜测。对于结构化抽取,开发者声明一种形状——一张发票、一个预订、一条通知——交出杂乱的文本,得到带类型的字段;公司称解码语法保证输出可解析,且抽取能很好地泛化到分类问题。同一模型还返回文本嵌入向量,因此应用无需离开设备即可在本地搜索、匹配和路由。产品页面列出的目标领域包括:智能家居,其中“调暗卧室灯并锁门”变成两次离线执行的调用;机器人;手机;穿戴设备;AR 眼镜;汽车;以及对电脑的纯英语控制。
微调路径按该领域标准算便宜。Cactus 提供三次托管微调运行,一次性 19 美元,含算力和训练数据生成,开源包支持在冻结的 20 层基础模型上进行本地 LoRA(低秩适应)微调,然后导出任意子网络的 4-bit .cact 文件,在同一引擎上运行:
needle finetune data.jsonl --epochs 10 --out adapter.safetensors needle build --lora adapter.safetensors --out tuned.cact
Python 循环同样简短——装饰一个函数,run() 通过执行该函数并返回其结果来完成循环:
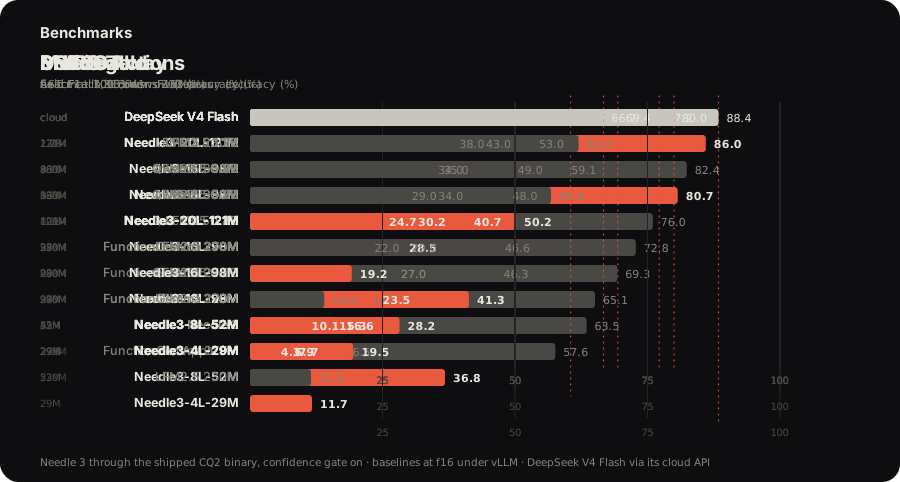
文章详述基准该如何解读:工具调用用精确匹配准确率,抽取用字段微观 F1,比较条件包括 CQ2-bit 二进制对 f16 基线。
import needle
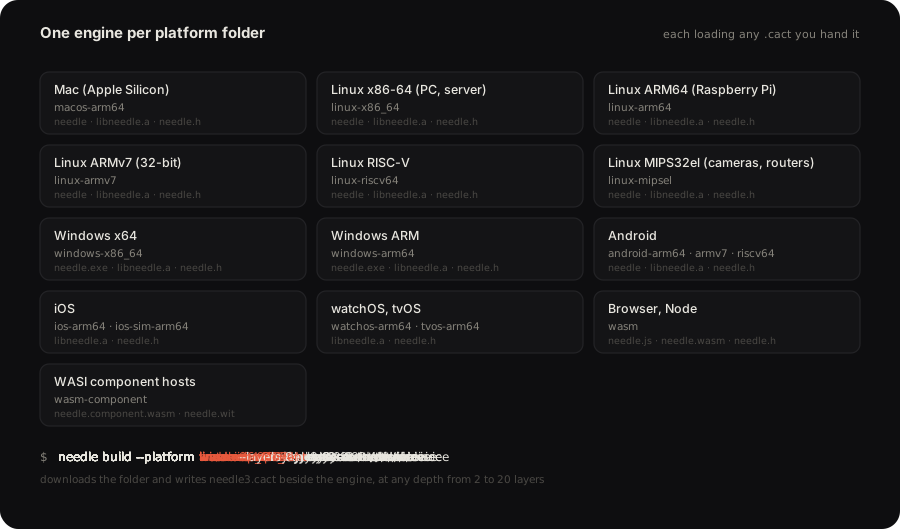
文章列出广泛的部署平台,包括 macOS、x86_64/arm64/armv7/riscv64/mipsel 上的 Linux、Windows、Android、iOS、tvOS、watchOS、浏览器端 WASM 和 WASI 组件。
@needle.tool def get_weather(city: str): "Get the current weather for a city." return {"city": city, "temp_c": 27, "sky": "clear"}
agent = needle.Needle(tools=[get_weather]) print(agent.run("what's it like in Lagos right now?")["results"]) # [{'city': 'Lagos', 'temp_c': 27, 'sky': 'clear'}]
每一轮返回一个 JSON 对象,包含函数调用、模型的推理过程、校准后的置信度分数,以及计时和内存数据。那个置信度分数是决定模型是否足够可靠以用于真实产品的设计中最关键的部分。引擎设置了 0.1 的下限:低于它时,调用会被收进 suppressed_calls 字段,function_calls 为空。高于它时,公司自家的指导是根据分数路由——分数高时立即执行,中等时展示调用并询问,空结果视为拒绝。标记了 triggers 的工具对匹配请求总会产生调用,因此分数告诉开发者是直接运行还是先确认。公司直言工具设计是“整个游戏的关键”:模型按字面读取 schema,因此一个带有朴素描述的窄域工具胜过一个宽泛的工具,工具集中的每一个额外工具都是一次误路由的机会。
这也是模型诚实的局限显现之处,GitHub README 直陈最大的一点:该产品“以通用聊天能力为代价”。Needle 3 不是聊天机器人,也不打算做。它是一个自动化模型:调用工具、抽取字段、嵌入句子。它关于编写工具的指导——每个动作一个工具、名称取自用户措辞、描述中拼明数值格式、必填参数给默认值、每轮工具集要小——实际上是一份模型可能失败的方式清单。公司称抽取“能很好地泛化到分类问题”的说法限于其自家套件;源材料未提供独立证据证明它能泛化到任意分类任务,而这种窄域性正是其速度和体量小的根本所在。
如何解读这些基准测试值得说明,因为“媲美 DeepSeek V4 Flash”容易被过度解读。公布的数字来自厂商自家套件,在完整测试分割上运行:工具调用用精确匹配准确率,抽取用字段微观 F1。工具套件包括 Mobile Actions(手机指令到 Android intent)、DroidCall(手机请求,部分需两次调用)和 BFCL v4(Berkeley 函数调用,单轮);抽取套件包括 DSTC8、SNIPS gold 和 SNIPS 7-way。比较条件已指明:Needle 3 子网络通过发布的 CQ2-bit 二进制(Cactus Quants,公司的 2-bit 量化)运行,而基线在 vLLM 推理引擎下以 f16 精度运行,DeepSeek V4 Flash 通过其云 API 访问。因此该宣称是:一个 2-bit、设备端的子网络在一手可数的工具调用和抽取套件上,得分能与一个大得多、云端服务的、全精度模型媲美——而非在通用意义上媲美 DeepSeek V4 Flash。微调数据强化了同一点:在 DroidCall 上微调使每个子网络提升 18 到 36 分,从 4 层起,微调后的子网络超过 DeepSeek V4 Flash,起步于 2900 万参数。
部署范围广泛。每个目标平台都附带一个 1 MB 以下的预构建引擎,启动时加载 needle3.cact 权重,needle build 为平台获取引擎并将权重置于其旁。平台包括 macOS、x86_64/arm64/armv7/riscv64/mipsel 上的 Linux、Windows、Android、iOS、tvOS、watchOS、浏览器端 WebAssembly (WASM) 以及 WebAssembly System Interface (WASI) 组件。开发者可构建任意子网络——例如给树莓派的 8 层版本——Cactus Platform 为不想自建流水线的团队提供完整路径(数据集、2-bit 量化、评测、微调和数据集管理),运行在公司基础设施上。
尚不确定的是厂商自家套件与现实使用之间的差距。公布的数字是 Cactus 自身的测量,在 Cactus 自身的基准上,针对一组特定的比较模型在特定条件下运行,源材料不包含独立审计。模型在模糊自然语言上的表现——那种会产生自信的错误调用而非拒绝的措辞——取决于工具描述的质量和置信度分数,后者在厂商数据上校准。模型公开可用,从 Python 包和 Hugging Face 上的权重,到拥有 12.9k star、875 fork 和 326 次提交的 GitHub 仓库,因此这些宣称可独立验证。对于围绕明确定义的工具集构建设备端自动化的团队,阶梯架构和 19 美元的微调路径值得按其本身的优劣评估。