编写异步应用要兼顾公平性与批量处理、竞争与隔离。拉塞尔·科恩(Russell Cohen)在文章《快速 Tokio 应用的编程原则》中指出了最常见的性能问题与优化策略。
**确定问题是否存在** 优化之前,先验证性能问题是否影响用户可见指标。作者指出,几乎每个真正的 Tokio 应用都会有比阿丽斯·丽尔(Alice Ryhl)建议的 10–100 微秒更长的轮询间隔(即 `.await` 点之间的时间)。但长轮询可能是良性的:一个应用可能有完全无害的长轮询,修复它们不会显著改善用户可见指标。最有用的 Tokio 指标是调度延迟直方图,它测量任务就绪后到 Tokio 实际轮询该未来的时间。
**为延迟分拆,为吞吐量批量处理** 低延迟需要公平性。粗糙的流水线实现可能导致一个客户的整个流水线等待另一个客户的流水线,显著增加延迟。显式地在每个请求后 yield,可以将延迟降低大约 10 倍;yield 几个连续就绪的读取则在牺牲更少的吞吐量的同时改善公平性。
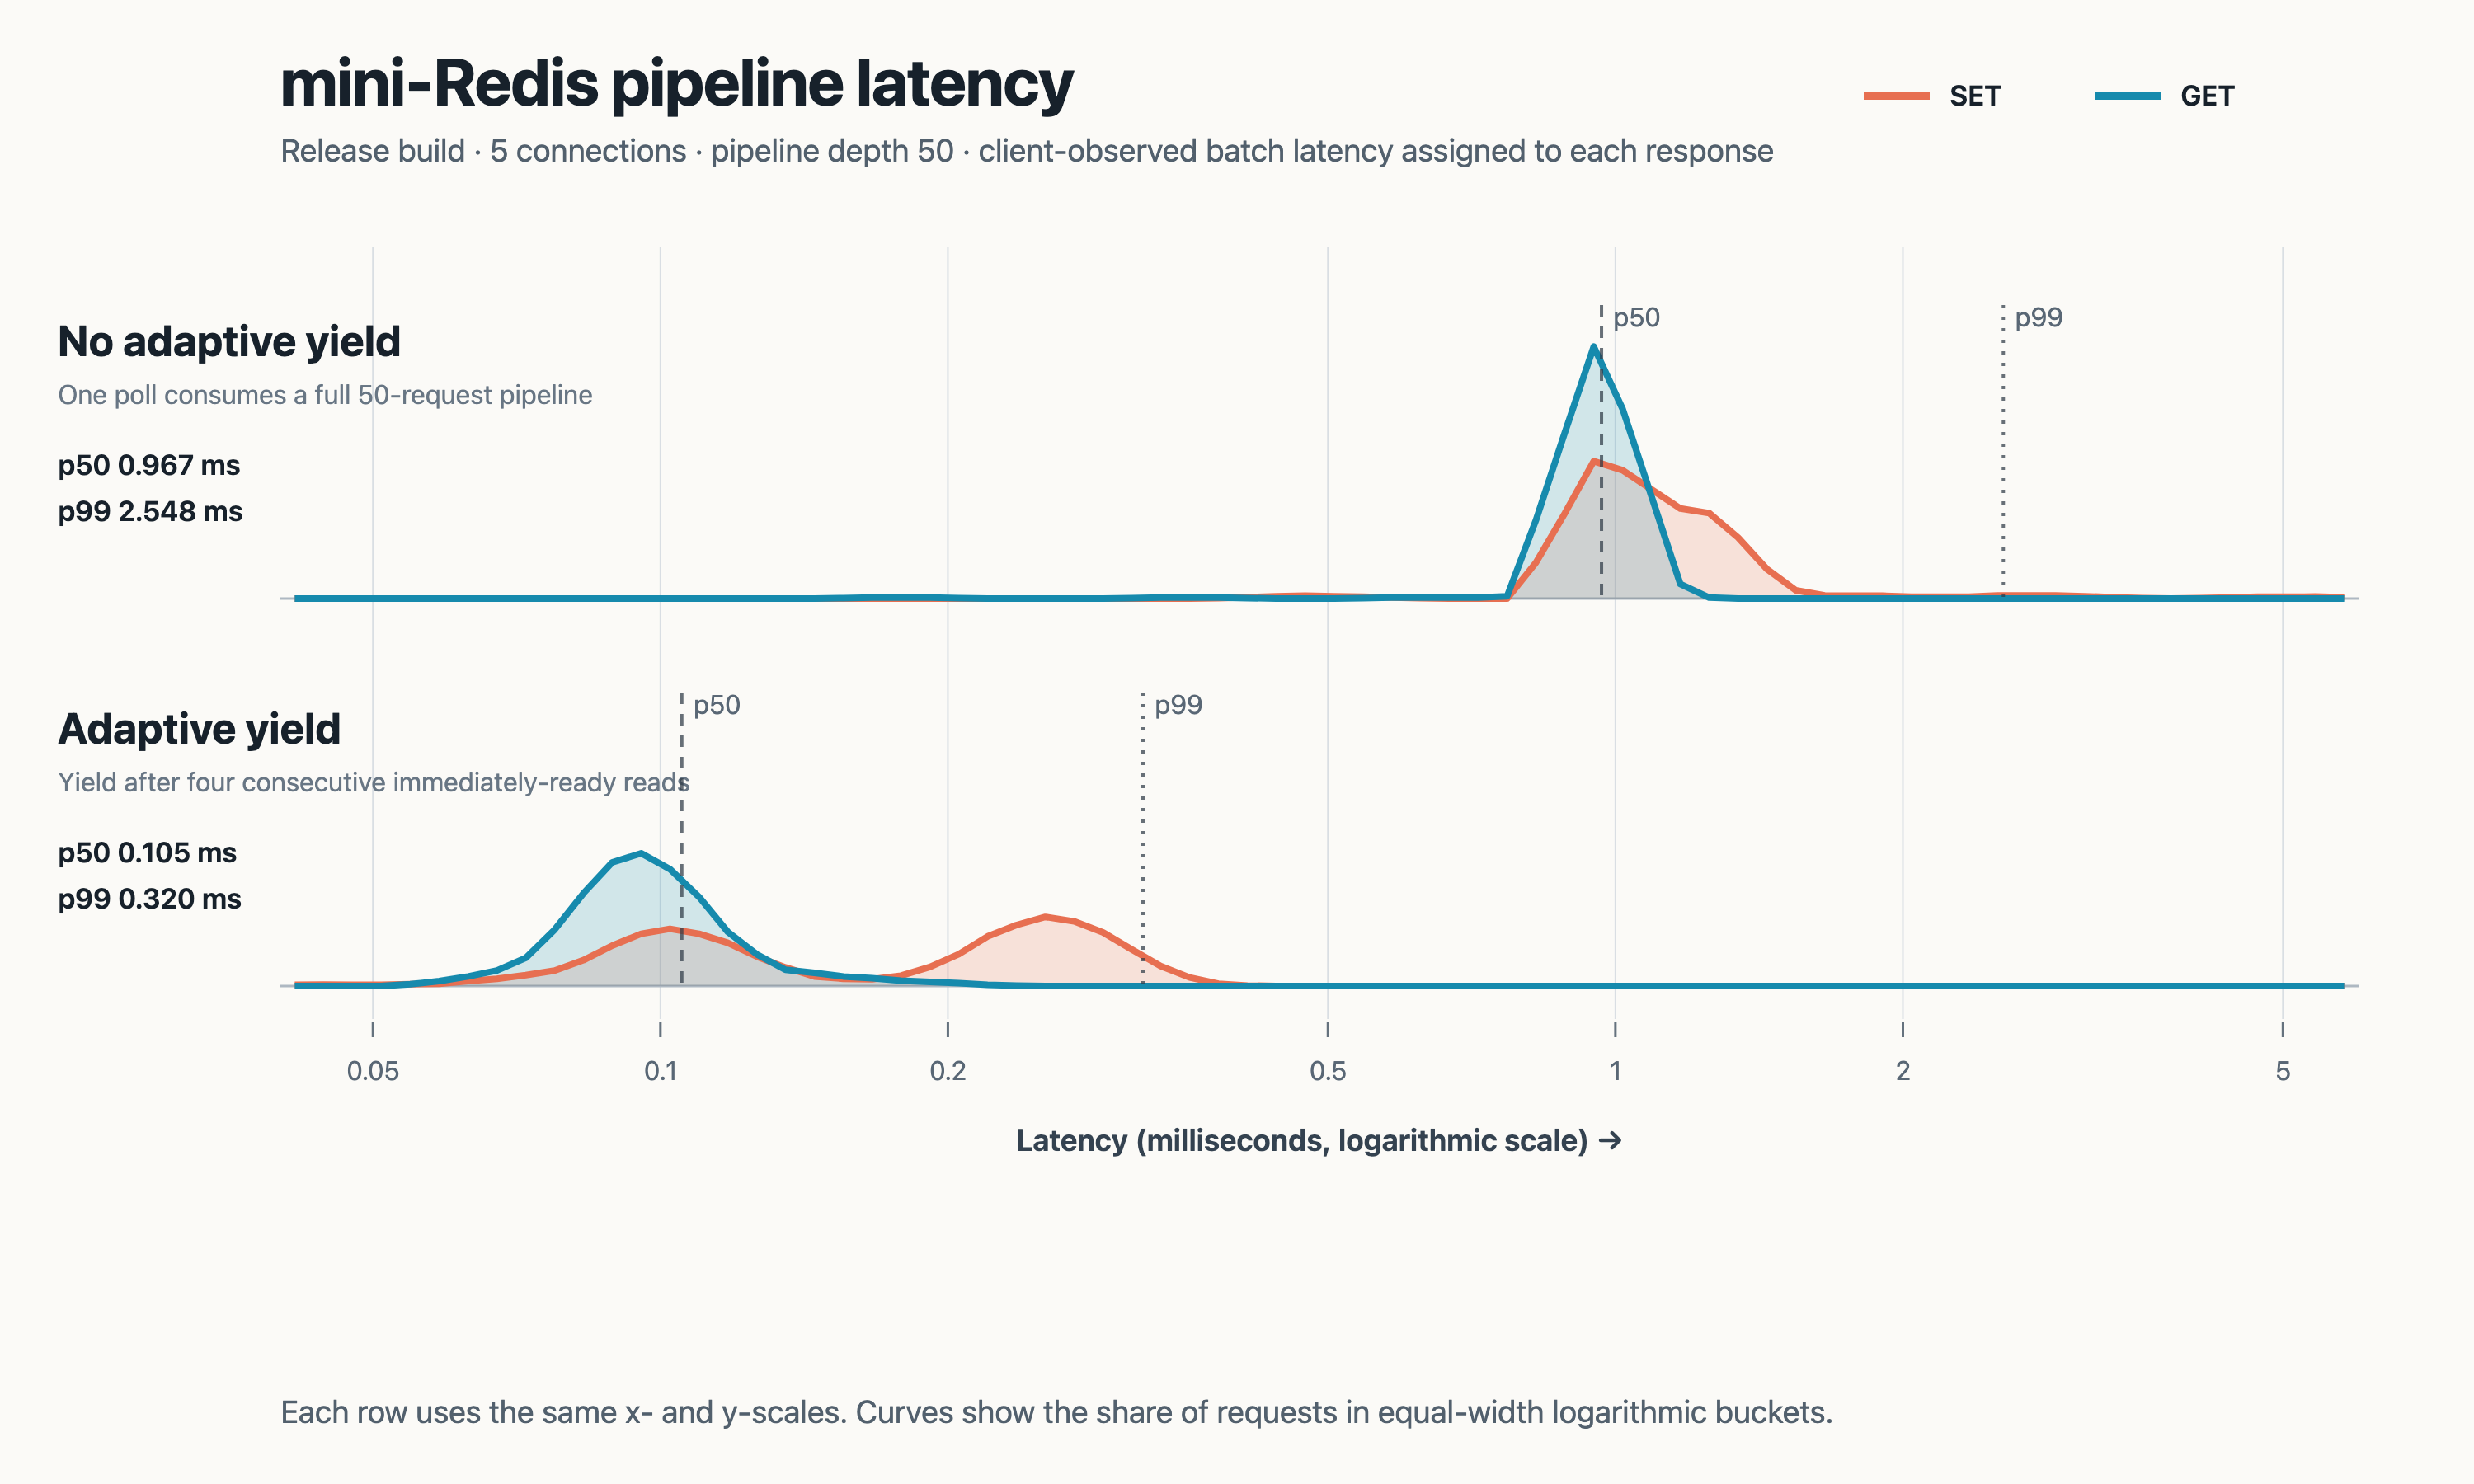
文章讨论了为延迟拆分工作与为吞吐量批量处理,指出在每个请求后 yield 可以大幅降低延迟,同时只牺牲少量吞吐量,Mini-Redis 的延迟测量结果即为此提供了例证。
为了提高吞吐量,将每个运行时事件的有用工作批量处理更有效。最好的例子是 `tokio::fs`:在没有 `io_uring` 的情况下,Tokio 将每个文件系统操作提交到一个共享的阻塞池中,而每个 `spawn_blocking` 调用都会带来开销。在进行一系列文件系统或阻塞操作时,将它们批量处理成最大合理的单元。在某些情况下,一个专用操作系统线程是一个更好的选择。
**警惕全局资源** Tokio 运行时有一个全局阻塞池和一个全局任务队列。在足够高的速率下,推送工作到阻塞队列会成为瓶颈;`spawn_blocking` 可能会出现在火焰图中。全局队列应该保持接近空。运行时范围内的操作,例如 `spawn_blocking`,在火焰图中很突出,表明队列可能持续很深。
**极度小心互斥锁** 让工作者阻塞在一个竞争激烈的互斥锁上可能会使整个运行时瘫痪。度量表注册表后的互斥锁或读写锁特别容易受到影响:如果一个刷新操作持有锁的同时进行昂贵的操作,那么每个 Tokio 工作者最终都会安排一个任务,阻塞在同一个锁上,使得抢占变得不可能。让关键部分极度短暂——例如一个哈希表更新。`RWLock` 几乎从来不是正确的原始语,因为它们在读路径上仍然会创建原子竞争。不要在刷新、进行 I/O 或 await 另一个 future 时持有锁。一个常见的技巧是先锁定再克隆数据;如果容忍重复读取,这可以将互斥锁持有时间限定在某个范围内。
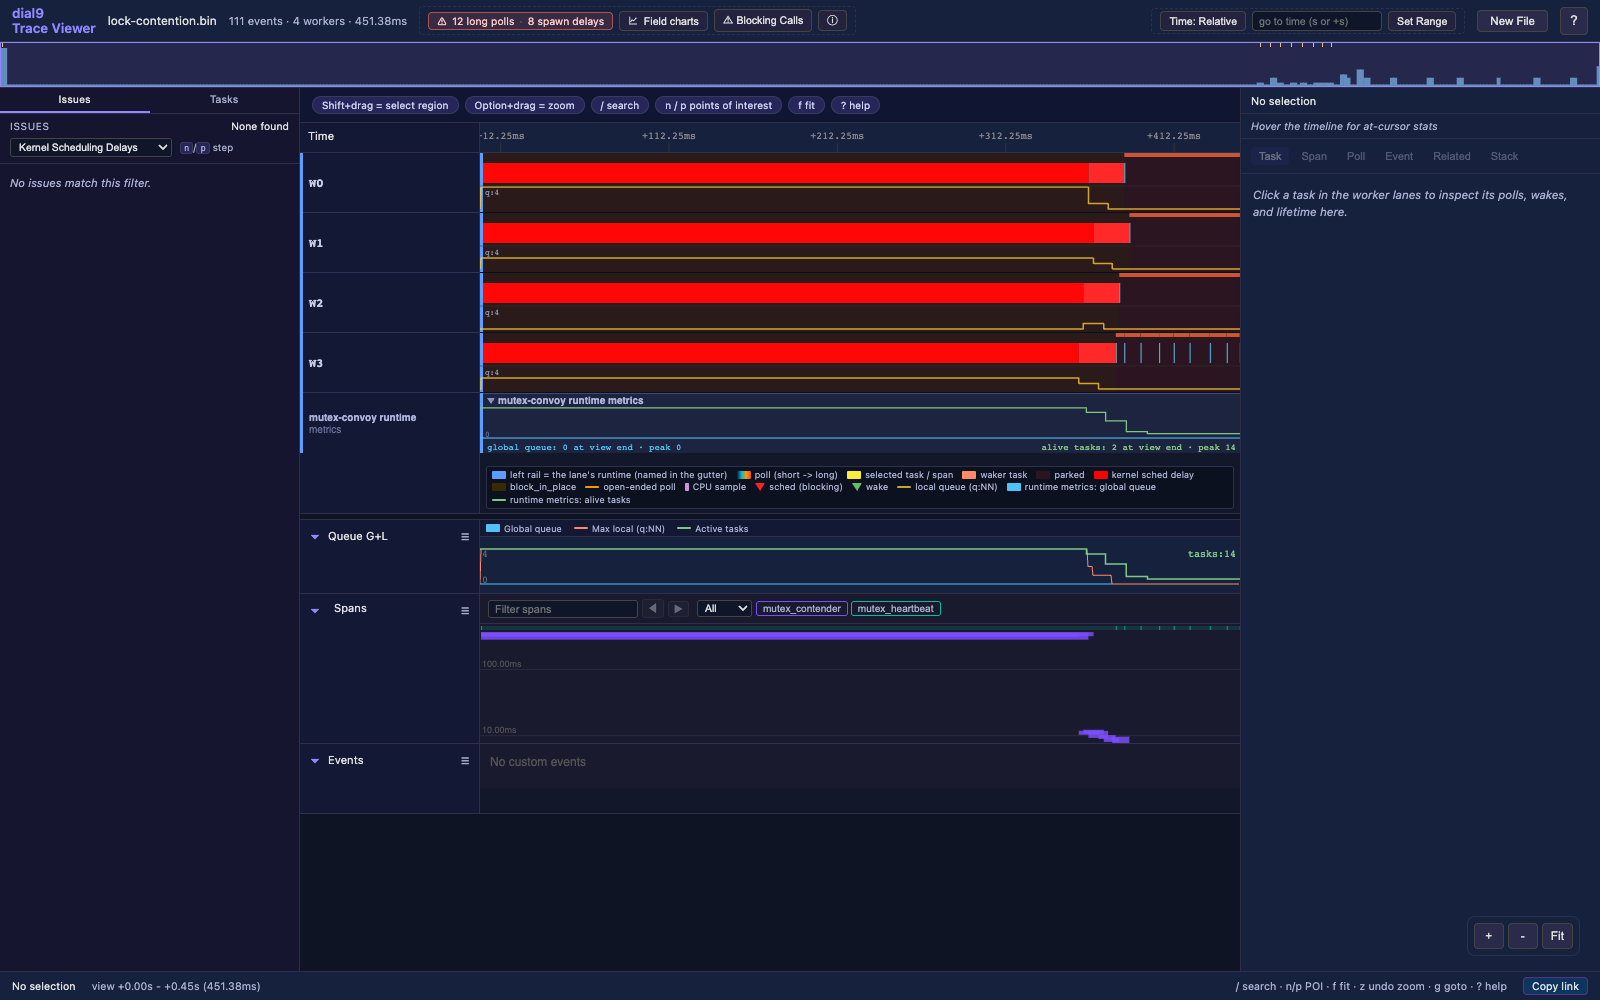
文章警告称,在竞争激烈的互斥锁上阻塞工作者可能导致整个运行时停滞,并展示了一条追踪曲线,其中互斥锁竞争引发了内核调度延迟以及工作者活动的减少。
`tokio::sync::Mutex` 交易一个问题换另一个问题:它锁更昂贵,并易受 `FutureLock` 等微妙问题的影响,只有当关键部分持续数毫秒时才适用。考虑使用通道代替,一个任务拥有共享数据,通道消息表示变更。
**通常限制并行性** Tokio 可以愉快地创建一个比整个系统能处理的请求更多的任务。意外地打开数千个并发连接是常见的。答案是无聊的:限制并发性。`Semaphore` 通常足够了;精细的适应性算法有时合适,但会增加复杂性。
**隔离 Tokio 工作者与其他线程** 如果操作系统负载过高,那么可能需要 10–20 毫秒(或者更多)才能为 Tokio 工作者调度 CPU。单数字毫秒的 P99 延迟是一个灾难。通过 `cgroups` 或相关 API 将 Tokio 工作者固定到专用 CPU 核心是最基本的解决方案。来自背景线程(例如,`tracing_appender`)的非关键性后台工作如果不 yielding 超过 100 毫秒,也会出现相同的问题。将非关键性后台工作转移到自己的核心,并将 Tokio 工作者重新定位到其他核心,通常可以改善延迟。
**当你更了解时,会有技巧** 在理想化的异步应用中,所有工作都发生在频繁 yield 的 Tiny Bursts 中。现实世界并不总是这样,而 Tiny Bursts 并不是运行软件最快的方式。在轻负载下,Tokio 的工作抢占可以补偿一个工作者被占用更长时间的情况——但这种情况在运行时或操作系统负载较重时会失败。在这两种情况下,抢占需要更长时间,而内核维护(如驱动 I/O)可能无法频繁到足以维持低延迟。
阻塞执行者在轻负载时是可以接受的,但这种建议不适用于使用 `tokio::join!` 或 `tokio::select!` 的情况,因为它们使用了任务内并发。在单个任务内,阻塞会阻止其他任务的进展,有时会表现为意外的超时。
最强的隔离措施来自将工作分配给单独的运行时,并为这些运行时固定到专用核心。许多网络服务都有延迟敏感型工作和较低优先级的后台工作;将它们分配到单独的运行时可以建立一个调度边界。在 TokioConf 上,大多数发言者最终都转向了一个至少有两个运行时的解决方案。
**通过自旋保持控制** 通过自旋保持控制是一个非常高级的策略,用于追逐微秒级别的延迟。这通常不建议使用。