2026 年 9 月中旬,一种新型语言模型进入公众视野。TypeSafe AI 宣布推出 Jev,这是该公司所谓的“System One”模型家族的首款产品。Jev 不进行聊天、不编写代码,也不生成开放式文本。相反,它接收非结构化输入——如文档、消息、程序状态——并返回类型化的概率决策:分类、评分、路由选择、提取。其开发者将其定位为“分类领域的 ChatGPT 时刻”:一个单一的通用模型,可以在无需长期标准做法中的按任务微调的情况下,廉价地处理多样化的分类任务。
此次发布伴随着 Sebastian Raschka 的技术回顾文章,该文章回顾了文本分类的历史——从词袋模型和朴素贝叶斯到循环神经网络和卷积神经网络,再到现代 Transformer——旨在界定 Jev 改变了什么以及它没有改变什么。
## 从词袋模型到校准决策
Raschka 的文章从词袋模型时代开始,在那个时代,文本被简化为固定大小的词频向量,输入到朴素贝叶斯、逻辑回归或 XGBoost 中。这种方法速度快且具有可解释性,但它丢弃了词序:“狗咬人”和“人咬狗”变成了相同的向量。N-grams 可以恢复部分局部结构,但代价是词汇量的爆炸。
深度学习引入了词嵌入——代表单个单词的稠密向量——使循环神经网络 (RNN) 和卷积神经网络 (CNN) 能够对序列和局部上下文建模。RNN 按步骤处理 token,维护一个总结历史的隐藏状态;LSTM 和 GRU 加入了门控机制以缓解梯度消失问题。CNN 将学习到的滤波器滑动到相邻嵌入的窗口上,然后聚合为固定长度的表示。这两种架构都早于 Transformer,但更难训练且并行化程度较低。
2018 年的 ULMFiT 论文证明,在大型语料库上预训练 RNN 然后进行微调,可以在 IMDb 情感基准测试上达到 95.4% 的准确率,远高于从头开始训练的 LSTM 的 85.7% 以及词袋模型逻辑回归的 89.9%。迁移学习成为了主导范式,最终演变为基于 Transformer 的模型,如 BERT 和 GPT 系列。
## Jev 的不同之处
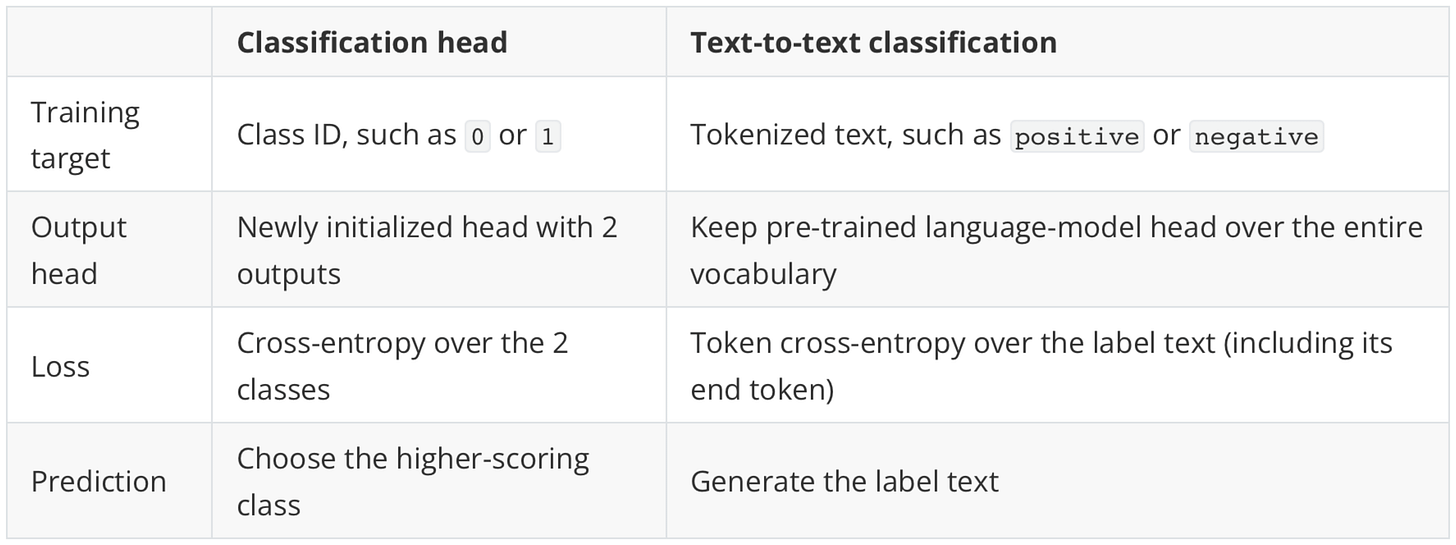
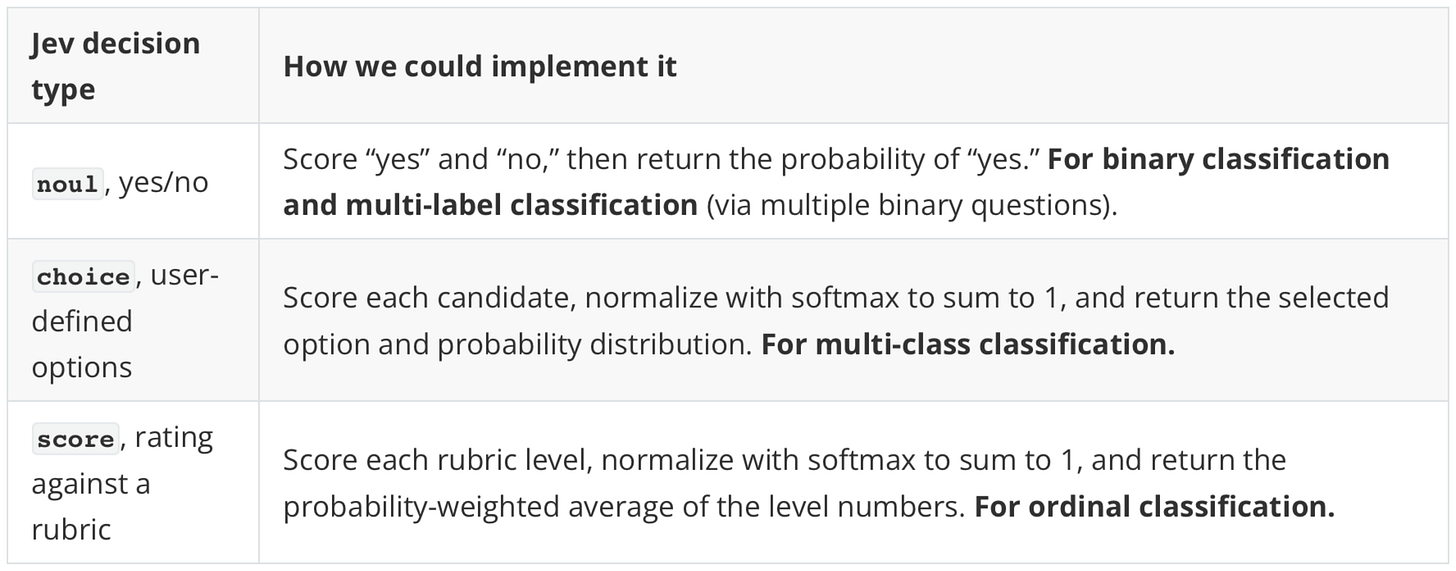
TypeSafe 的公告将 Jev 定位为在多个维度上偏离 LLM 范式的模型,首先是其输出空间:Jev 发出预先定义的结构化、类型安全的值——类别、分数、布尔标志。它无法生成自由格式的字符串,这从结构上消除了幻觉和解析失败。
TypeSafe 的公告将 Jev 定位为在多个维度上偏离 LLM 范式的模型: - **输出空间**:Jev 发出结构化的、类型安全的数值——预先定义的类别、分数、布尔标志。它无法生成自由格式的字符串,这从结构上消除了幻觉和解析失败。 - **采样**:在 LLM 按顺序生成 token(前沿模型端到端耗时 3–329 秒)的情况下,Jev 并行计算所有输出概率,在 70–500 毫秒内完成。 - **训练目标**:TypeSafe 开发了“校准决策强化学习”(RLCD),而非人类反馈强化学习 (RLHF) 或可验证奖励 (RLVR)。目标是“认识论上诚实的概率”:当 Jev 分配 90% 的置信度时,它大约应在 90% 的情况下正确,且相似的输入应产生相似的置信度分布。 - **经济效益**:输入 token 成本为每百万 $0.042(相比 LLM 的 $0.20–$10);输出 token 被描述为“便宜到无需计费”,因为模型不生成变长序列。
在 LLM 按顺序生成 token(前沿模型端到端耗时 3–329 秒)的情况下,Jev 并行计算所有输出概率,在 70–500 毫秒内完成。其输入 token 成本为每百万 $0.042,而 LLM 为 $0.20–$10,且输出 token 被描述为便宜到无需计费,因为模型不生成变长序列。
Raschka 指出,Jev 处于两个极端之间:既不是能够分类但速度慢且昂贵的通用 LLM,也不是针对单一任务速度快且便宜但缺乏通用性的窄领域专用分类器。Jev 的卖点是兼顾广度和速度——一个模型即可用于路由、评分、提取、护栏检查和实时决策分支。
## 校准作为自动化的赋能者
校准的声明是自动化论点的核心。传统的 LLM,即使在要求提供置信度时,往往也倾向于过度自信且不一致。如果一个模型在 95% 的情况下成功,但无法发出信号告知哪 5% 的情况会失败,下游软件在没有人工审查的情况下就无法安全地基于其输出采取行动。Jev 的 RLCD 训练明确针对报告概率的可靠性进行优化,而不仅仅是 Top-1 准确率。
TypeSafe 的对比演示展示了架构上的差异:Jev 在单次前向传播中返回预定义键的完整概率分布,而 LLM 则会逐个 token 生成 JSON 对象。并行设计还意味着延迟随模型大小缩放,而非随输出长度缩放。
## 范围与局限性
两个来源都谨慎地划定了边界。Raschka 强调,对于窄域且定义明确的问题,专用分类器可能会在准确性、速度和成本上击败 Jev。Jev 的价值在于通用性:“比那些特定任务的模型通用得多。” TypeSafe 承认长期定价的可持续性仍未得到证实,且发布的延迟数据来自位于当前服务区域的西海岸笔记本电脑。
该模型处于早期访问阶段。来源包中未提供独立的基准测试或第三方评估。arXiv 参考(Raschka, 2014)提供了关于朴素贝叶斯的历史背景,但与 Jev 的性能无关。
## 技术社区为何产生反应
附在 Hacker News 提交上的讨论线索捕捉到了一个反复出现的主题:花费多年时间构建按任务分类器的开发者看到 Jev 是一个潜在的拐点——一个模型,无需微调,立即获得结构化输出。与 ChatGPT 对文本生成影响的类比是明确的:一个通用工具,去除了广泛问题类别中的定制工程步骤。
Jev 是否能在大规模上兑现这一承诺仍有待验证。但其架构选择——并行结构化输出、校准概率、固定模式决策——代表了对于那些本质上属于分类任务的 AI 工作负载,相对于主流 LLM 范式的一种连贯替代方案。
],