Hister 是一款自托管搜索引擎,它会根据你访问的网页、浏览器历史与书签、本地文件以及你选择抓取的网站来构建个人索引。与查询实时网络的传统搜索引擎不同,Hister 会将提取出的文档内容与其搜索索引一起存储在你自己运行的服务器上,因此即使原始页面发生变更或消失,信息依然可以被检索到。
## 工作原理
你可以在本地或你控制的机器上运行 Hister 服务器。适用于 Firefox 或 Chrome 的浏览器扩展可以在你访问页面时自动为其建立索引。你也可以导入现有的浏览器历史和书签,监视本地目录中的新文件,或抓取特定网站。服务器会从 HTML、PDF 及其他支持的格式中提取文本,然后为完整内容建立索引——而不仅仅是标题和 URL。
同一索引可通过多种界面进行检索:位于 `http://127.0.0.1:4433` 的网页界面、基于终端的界面(TUI)、命令行工具、HTTP API,以及一个 MCP(模型上下文协议)端点,可让 AI 助手直接获取结果。
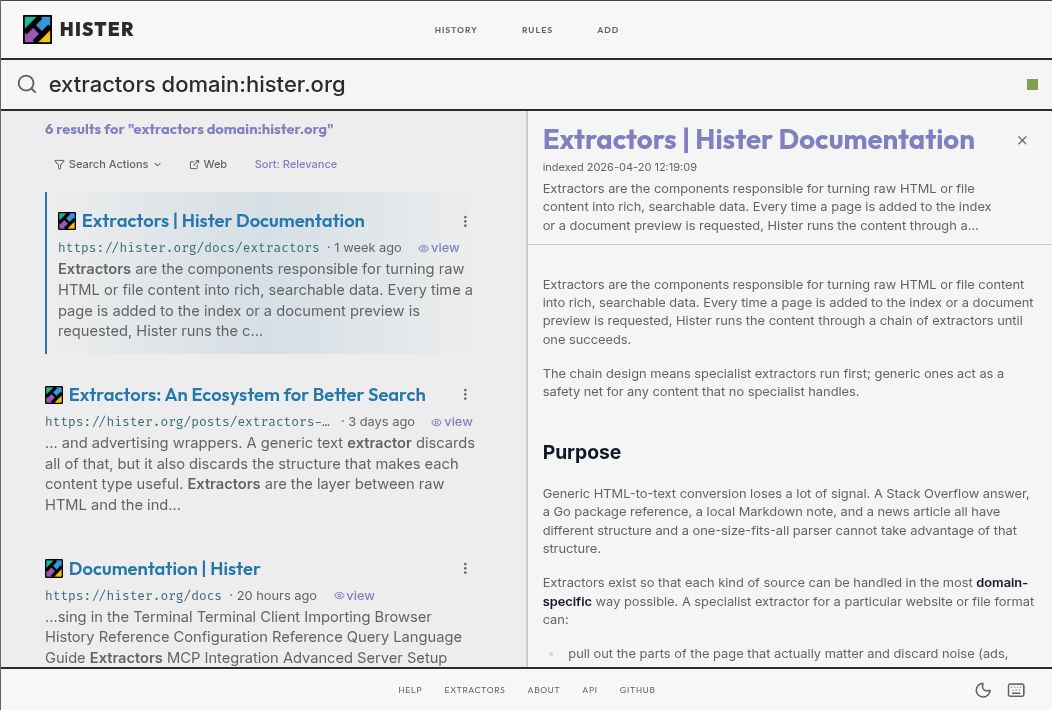
此图展示了位于 http://127.0.0.1:4433 的 Hister 网页用户界面,用户可在其中检索其已索引的页面和文件,查看存储内容的易读预览,并在不离开检索界面的情况下浏览结果。
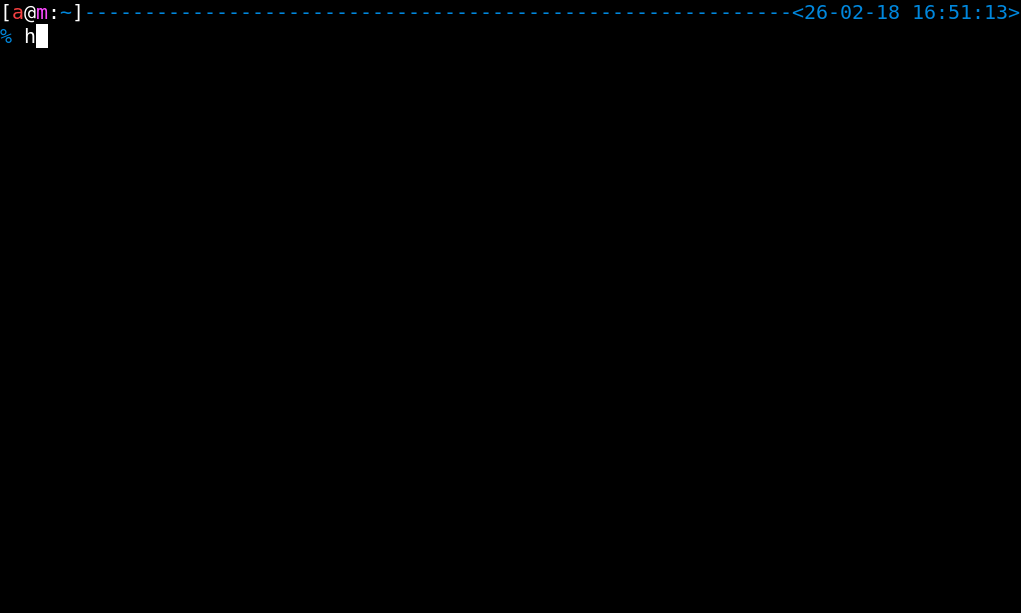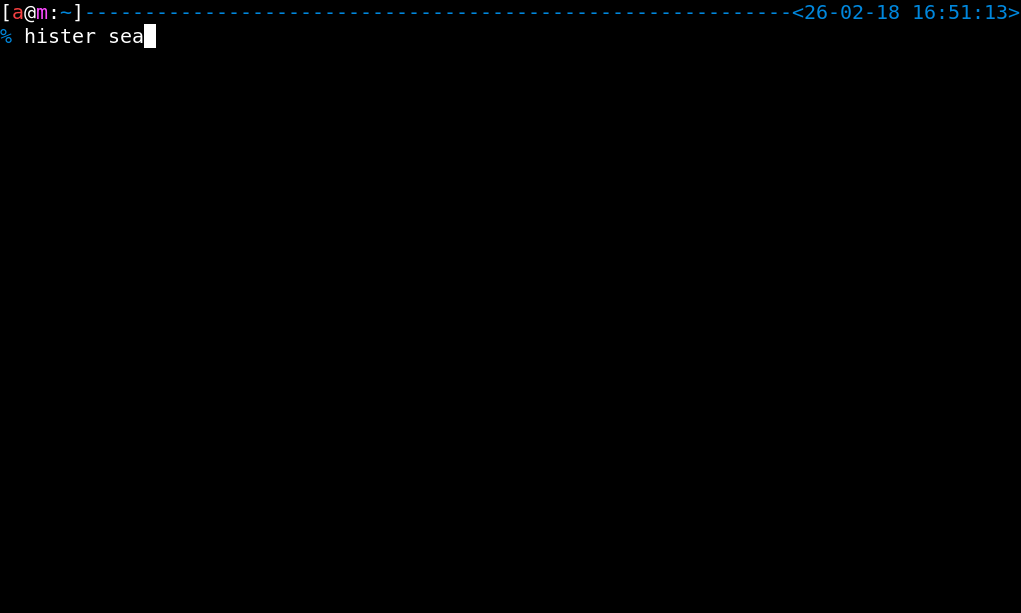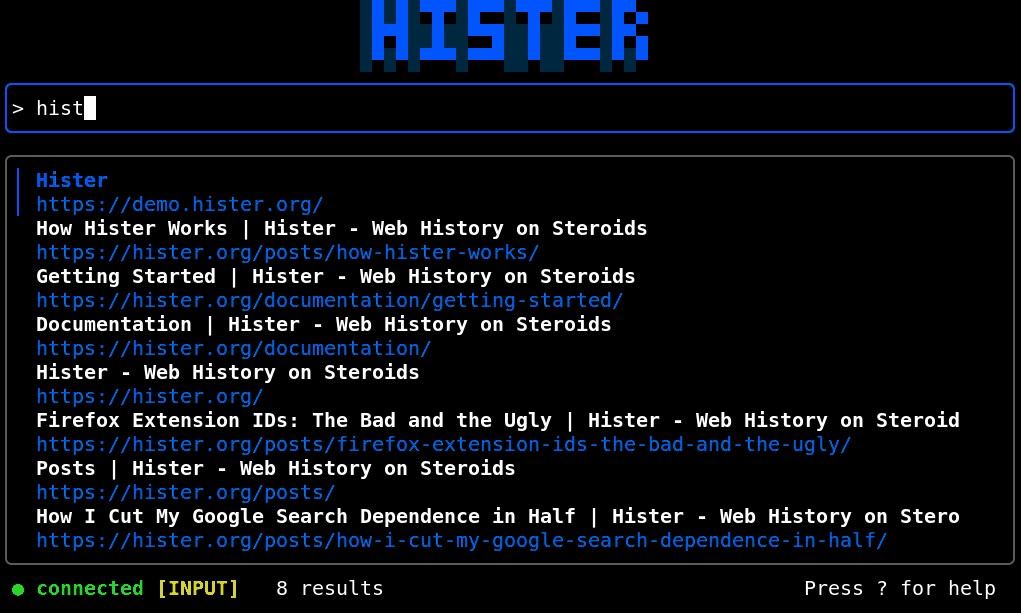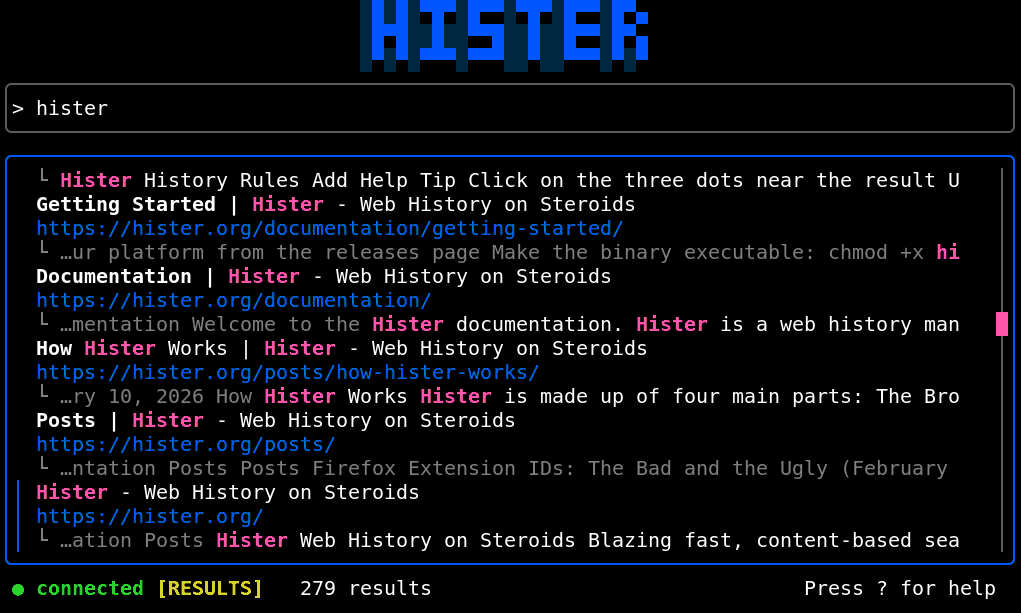
此动画 gif 展示了 Hister 的终端用户界面,它提供了一种由键盘驱动的方式来检索个人索引、浏览结果,并从命令行访问与网页界面相同的全部功能。
## 检索能力
Hister 支持比简单关键词更丰富的查询语言:
- **字段过滤器**,用于在特定属性范围内检索,例如 `url:`、`title:` 或 `domain:` - **引号短语**,用于精确匹配 - **通配符与否定**(例如 `python -snake`) - **日期范围**,用于按页面索引时间缩小范围 - **查询别名**,用于可复用的复杂查询 - **结果优先级**,用于提升某些来源的权重
可选的语义检索功能可让你按含义而非精确术语查找文档。这会将文档文本发送到你配置的嵌入端点——例如通过 Ollama 使用的本地模型或远程 API——因此你可以根据自己的隐私偏好启用或关闭该功能。
## 内容处理与预览
当 Hister 为某个页面建立索引时,它会将提取出的内容与搜索索引一同存储。搜索结果会在原始 URL 旁显示该存储内容的整洁、易读预览,让你无需离开检索界面即可核对匹配情况。由于内容存储在本地,即使源页面日后被编辑、加入付费墙或完全删除,它依然可以访问。
索引规则让你可以控制哪些内容会被建立索引以及其排名方式。跳过规则会排除匹配的 URL 或模式。优先级规则会提升来自首选来源的结果。版本跟踪可在文档发生变化时保留其早期版本。敏感内容检查可以标记或排除与你定义的模式相匹配的内容。
## 隐私模型
Hister 默认不包含遥测功能,也不发起任何外部网络请求。浏览器扩展仅将页面内容发送给你配置的 Hister 服务器(外加获取页面图标)。服务器会将文档和索引本地存储。可选的语义检索会将文本发送到你选择的嵌入端点。整个技术栈可以在单台机器上运行,无需任何云依赖。源代码采用 AGPLv3 许可证。
## 部署选项
单个二进制文件即可在 Linux、macOS 或 Windows 上运行,个人使用无需任何配置。对于共享服务器,Hister 支持多个用户及按用户隔离的文档,后端可使用 SQLite 或 PostgreSQL。提供 Docker 和 Nix 软件包。开发需要 Go 1.26、npm 以及用于 CGO 依赖的 C 编译器。
## 背景与局限性
该项目的作者曾开发过注重隐私的元搜索引擎 Searx,但在遇到元搜索模型的局限性后,转而采用了个人索引方法。Chrome 曾在 2008 年至 2013 年间包含类似的全文历史搜索功能,随后将其移除。
用户指出的当前局限性包括:浏览器扩展默认会为所有访问过的页面建立索引(一项建议的改进是设置停留时间阈值,例如仅索引查看时间超过 4 秒的页面),并且该软件尚未被打包进主流 Linux 发行版仓库,这被一些用户视为部署障碍。MCP 集成相对较新,其与各种 AI 助手的实际实用性仍由社区持续探索中。