将前沿人工智能模型整合到历史研究中,正从简单的行政任务转向主动的问题解决。虽然历史学家长期以来一直使用数字工具进行数据可视化,但现代模型现在展现出了多语言推理、高等数学以及跨大型离散数据集进行自主研究的能力。这些模型在“易处理”的历史领域特别有效,例如密码学、追踪跨语言的文本改编,以及综合尚未整合到更广泛学术研究中的小众子领域信息。例如,研究人员已利用这些模型识别出艾萨克·牛顿炼金术译文此前未知的来源,并分析了17世纪手稿中加密的页边注。通过将文本中的数学模式与历史日记进行交叉引用,人工智能可以识别不一致之处或确认特定思想影响的来源。然而,这些工具的有效性仍然受到数字化数据可用性的限制,且需要人类专业知识来验证研究结果。虽然人工智能可以处理庞大的档案,但导航物理档案所需的“直觉”——即在检索辅助工具不完整或不存在的情况下进行查找——仍然是一项独特的人类技能。历史学家通过亲临现场以及对难以辨认或无法量化的数据进行综合,从而对这些馆藏形成整体理解,这是当前人工智能模型尚无法复制的过程。因此,最有希望的前进道路在于协作努力,即人工智能充当研究伙伴,处理大规模的数据综合,而人类历史学家则提供必要的背景、验证和概念框架,以确保研究结果的准确性和重要性。
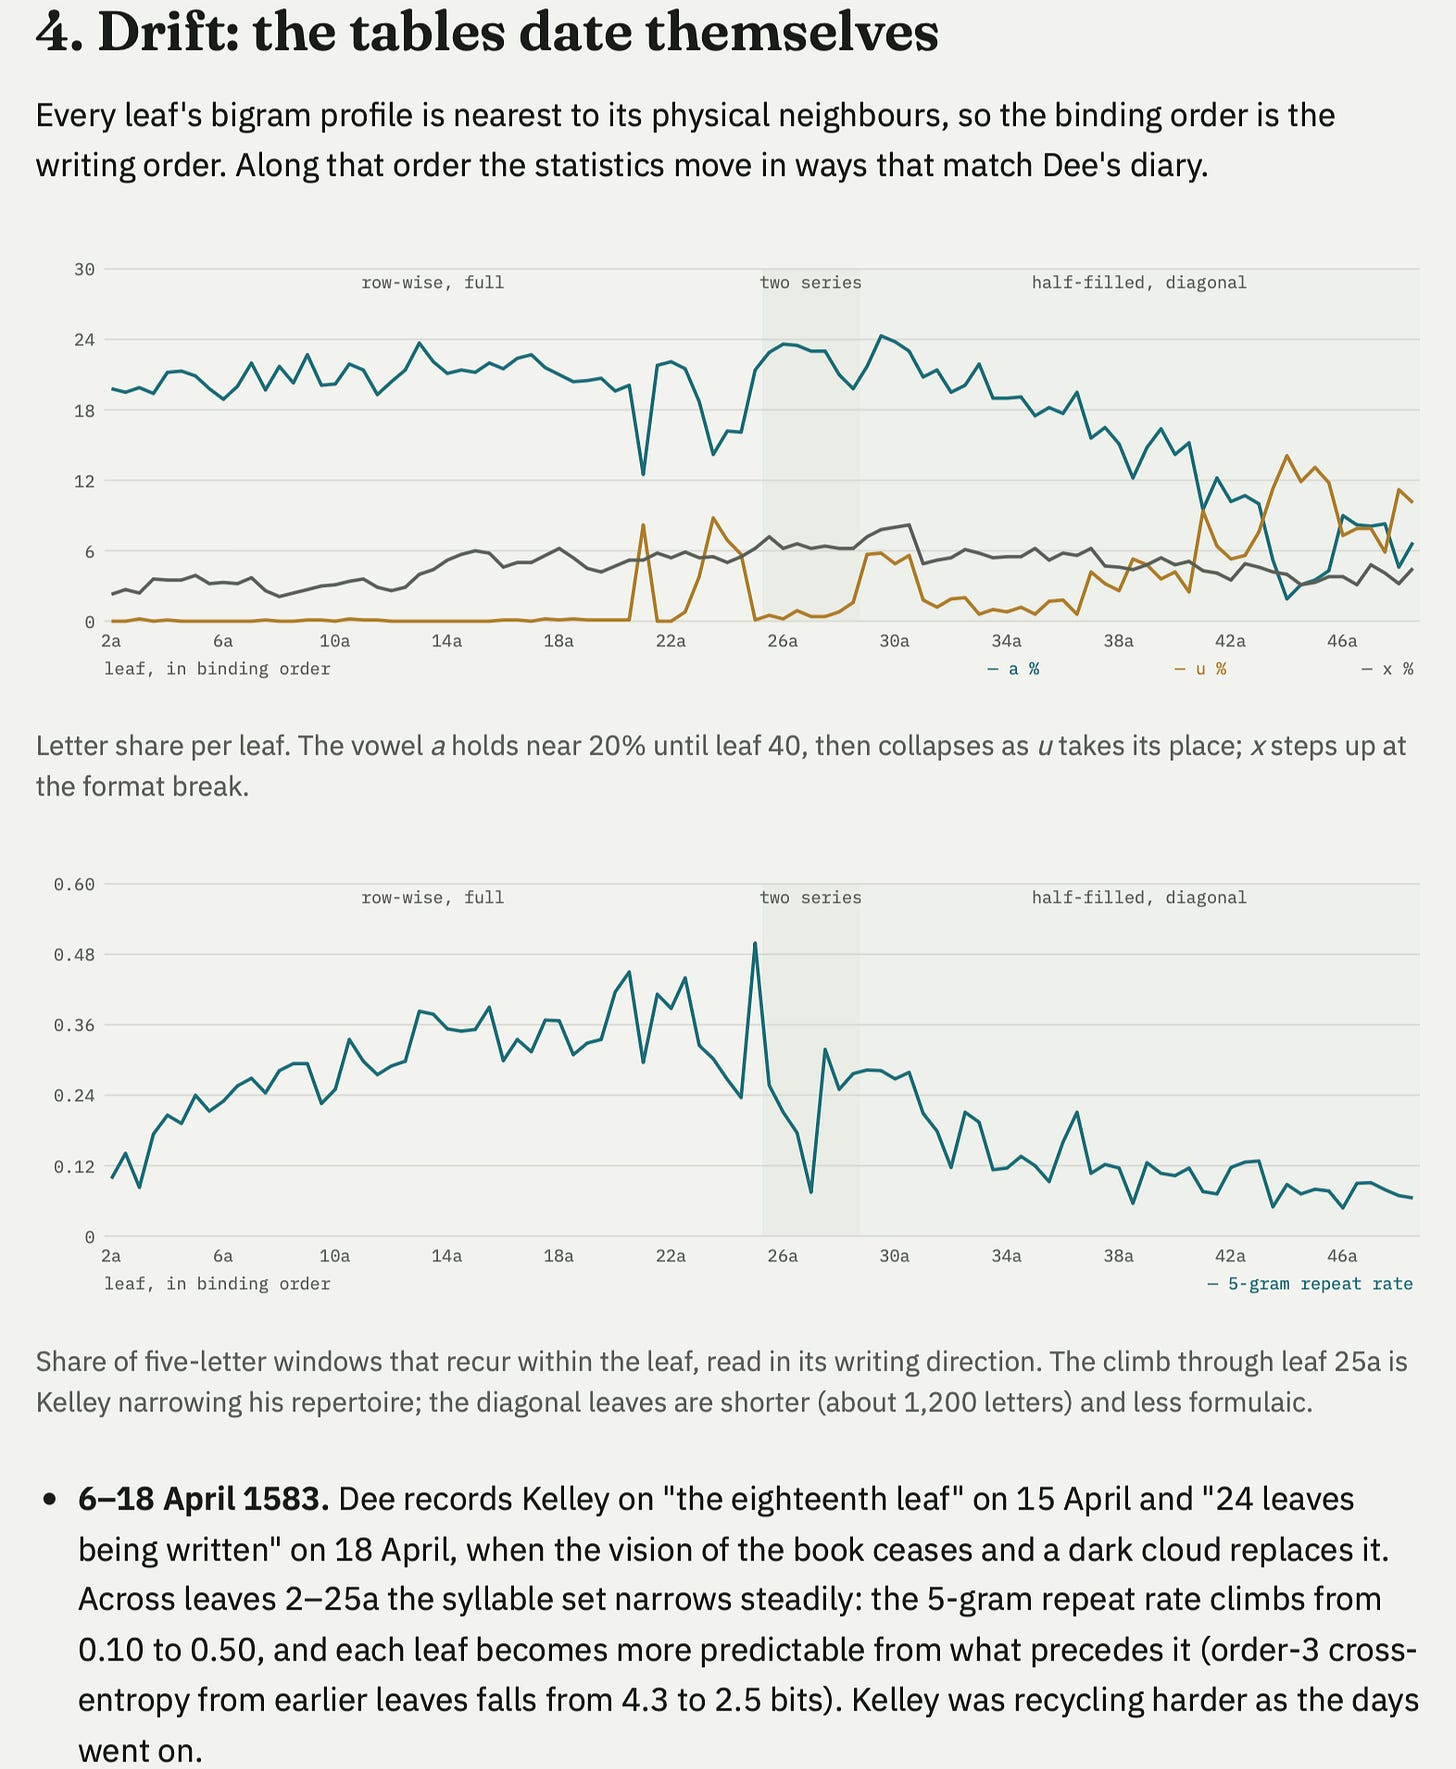
本文重点介绍了人工智能模型如何被用于分析17世纪手稿中的加密页边注和数学模式,以揭示隐藏的思想渊源。
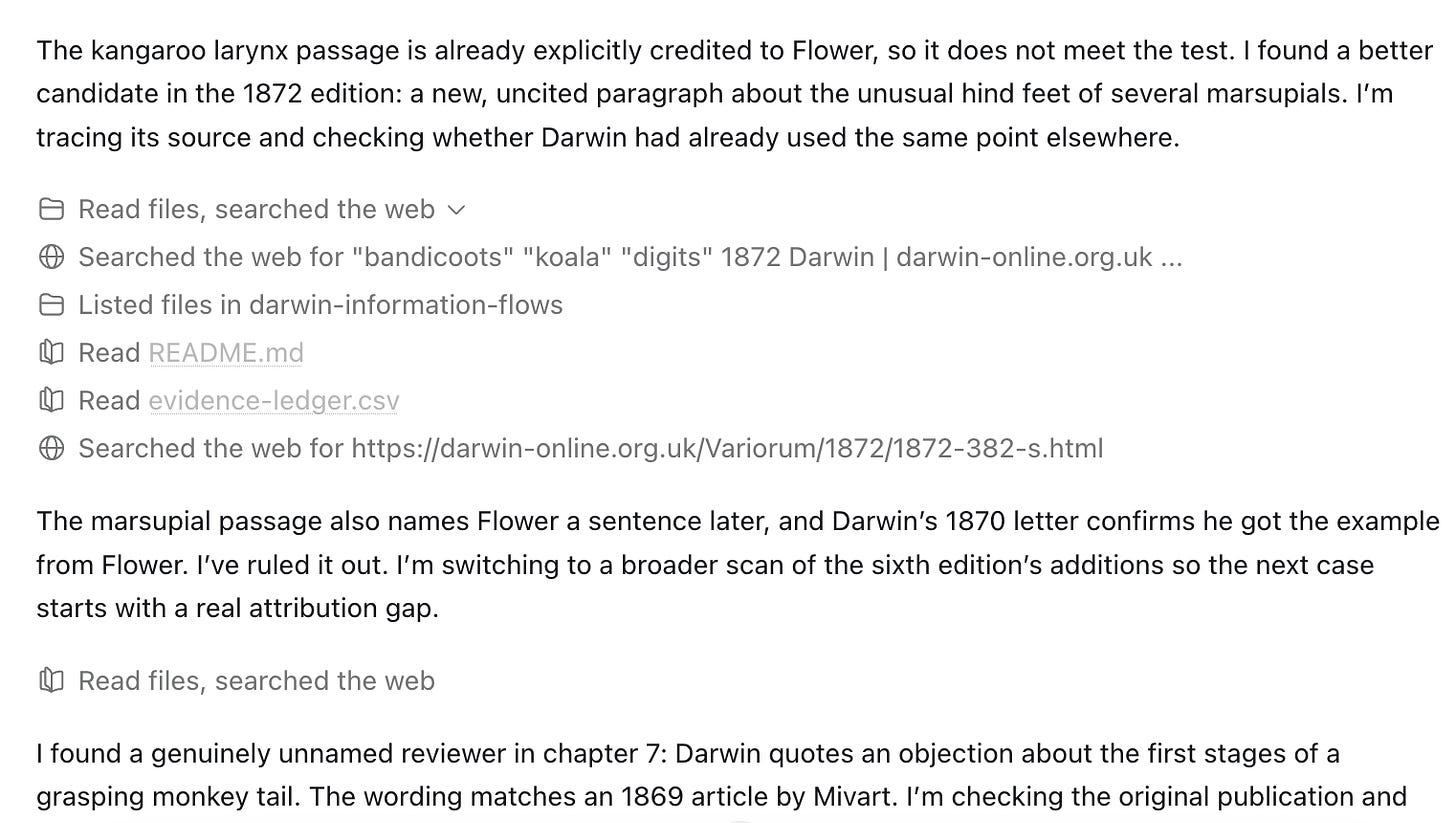
该图像展示了协作过程,即人工智能模型处理大规模数据综合,使人类历史学家能够专注于验证和概念框架的构建。