Kev 是一个基于 Qwen3.5 构建的开源小型决策模型系列,旨在本地运行,或在用户自行管理的端点上运行。该项目提供 0.8B、4B 和 9B 三种变体,以及训练代码、评估数据和与 TypeSafe 的 System One 接口兼容的 API。
该系统可在一次请求中回答多种问题类型:是或否决策、多项选择路由,以及数字评分。这些问题共享相同的输入文本,但彼此不能读取对方的内容,因此一张支持工单可以在不使答案相互依赖的情况下完成路由、升级检查,并获得沮丧程度评分。
该仓库还提供了一条实用的本地使用路径。文档说明了 CUDA、ROCm 和 Apple Silicon 的支持情况,并称 4B 和 9B 模型可以适配配备 32 GB 内存的 Mac。示例服务器默认绑定 localhost,而远程访问时可以要求提供 API 密钥。
最清晰的证据来自该项目的评估表。在“新来源”上,报告的测试准确率分别为 Kev-0.8B 的 0.684、Kev-4B 的 0.837,以及 Kev-9B 的 0.852;报告还显示,较大模型的 Brier 分数更低。这些是发布者报告的结果,并非独立验证。
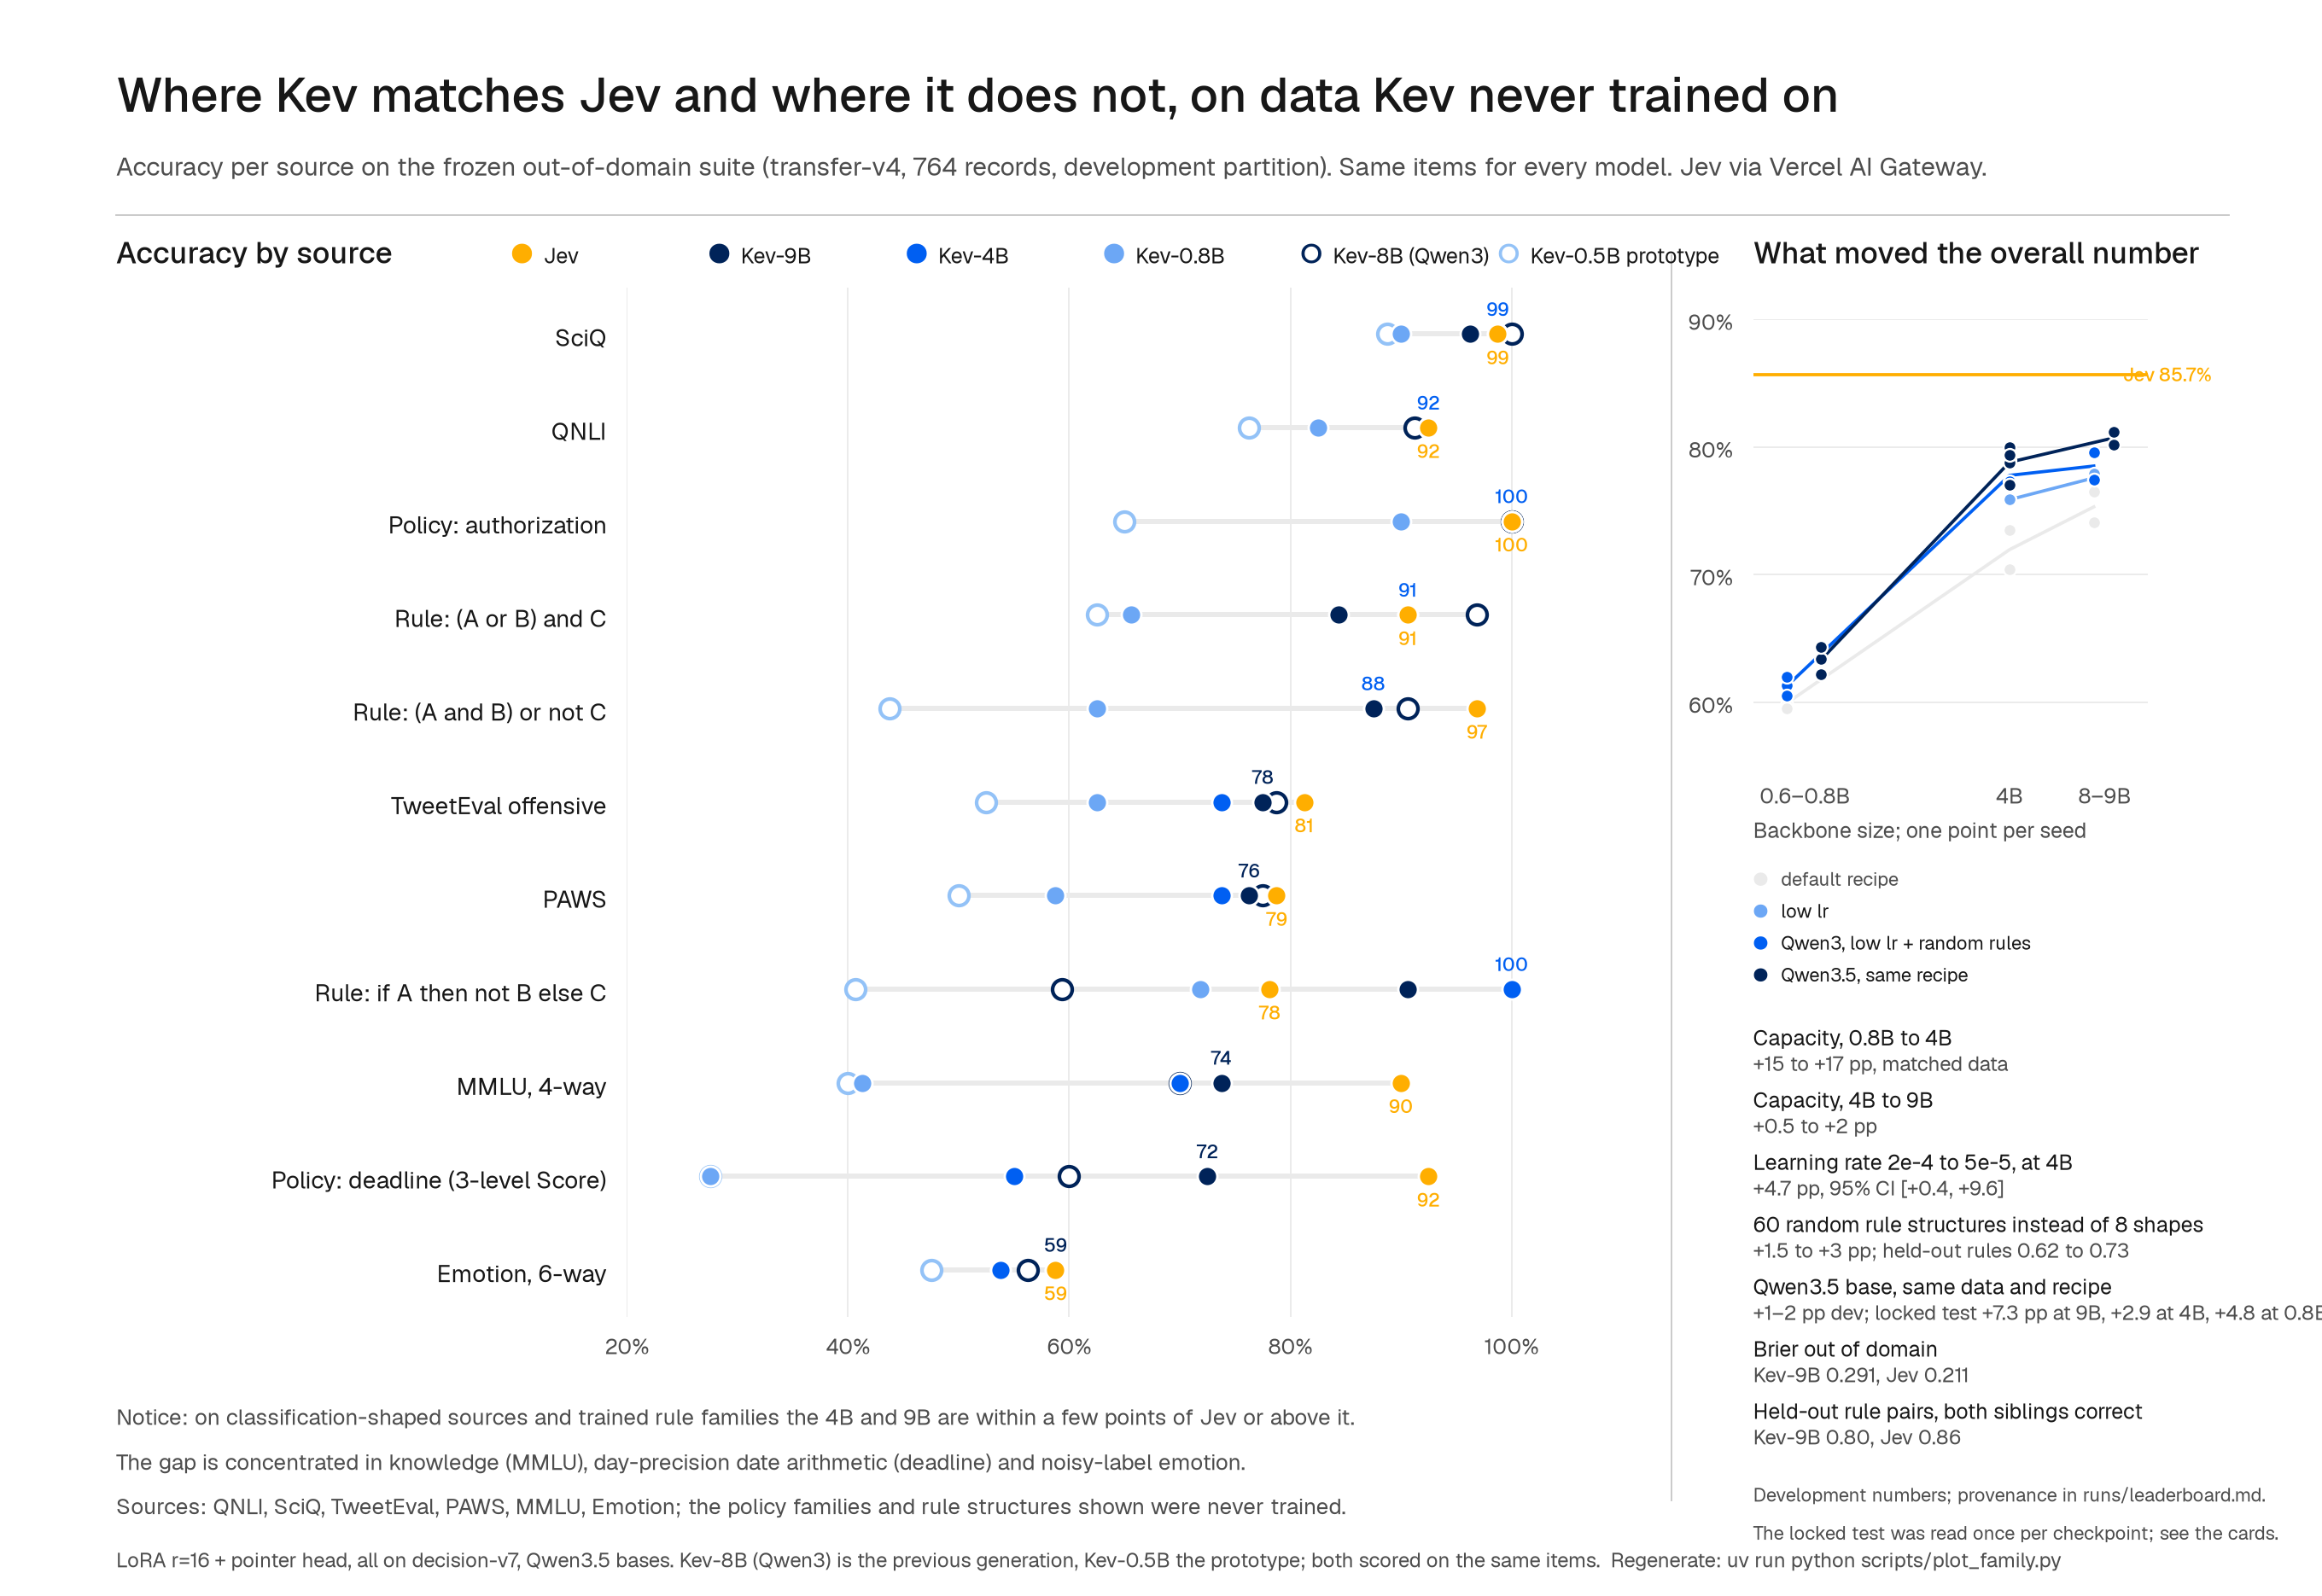
本文讨论了该项目报告的评估表,以及比较 Kev 与 Jev 时的限制;这张图表直接将这些按来源区分的结果可视化。
README 警告称,与 Jev 的比较并未受到控制,因为 Jev 的训练数据集未知。对于正在权衡 Kev 与类似系统的读者而言,这一点很重要:该资料包支持 Kev 所声明的设计及其自行报告的基准测试结果,但不支持一个确定性的主张,即 Kev 在总体上比 Jev 更准确。