Kage 是一个开源命令行项目,致力于通过把在线网站转换为静态、离线副本,来实现网络内容保存。其创建者介绍了这样一套流程:无界面 Chrome 会渲染每个页面,捕获完成后的 DOM,移除脚本,并将 CSS、图片和字体改写为本地路径。该仓库的核心理念是,由此生成的页面看起来与在线网站相同,同时不运行任何 JavaScript,也不发出网络请求。
这种区别很重要,因为常规浏览器保存操作可能只保留源代码标记,而无法重现页面在客户端渲染完成后的样子。Kage 则会先等待页面稳定下来,再抓取快照。换言之,该工具试图保存读者实际看到的渲染状态,而不只是服务器最初返回的 HTML。它适合文档、随笔、教程以及其他以内容价值为主、交互行为较少的相对静态网站。
该项目记录了一套简单明了的工作流程:`kage clone` 创建可浏览的镜像,`kage serve` 在本地进行预览,`kage pack` 则将镜像压缩为单一文件。clone 命令可以限制页面数量和抓取深度、跟随指定的路径前缀、包含子域名、滚动页面以触发延迟加载的资源,并支持在中断后继续。文档还称,爬虫会读取 `robots.txt`,并以 `sitemap.xml` 为起点安排任务,不过相关选项可以修改这些默认设置。
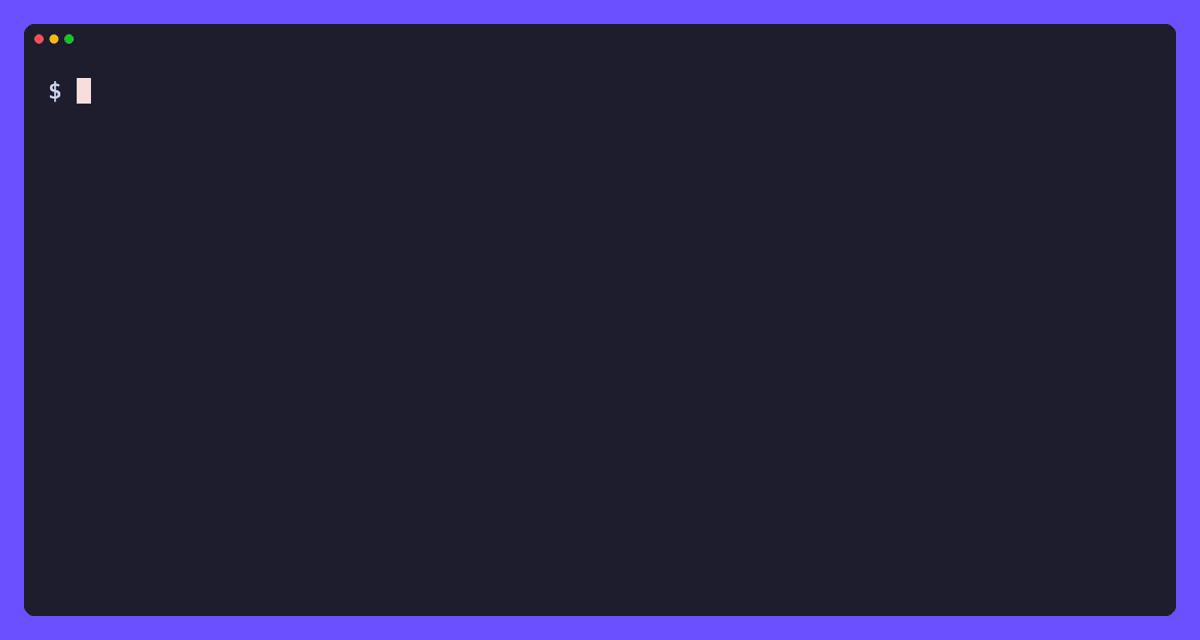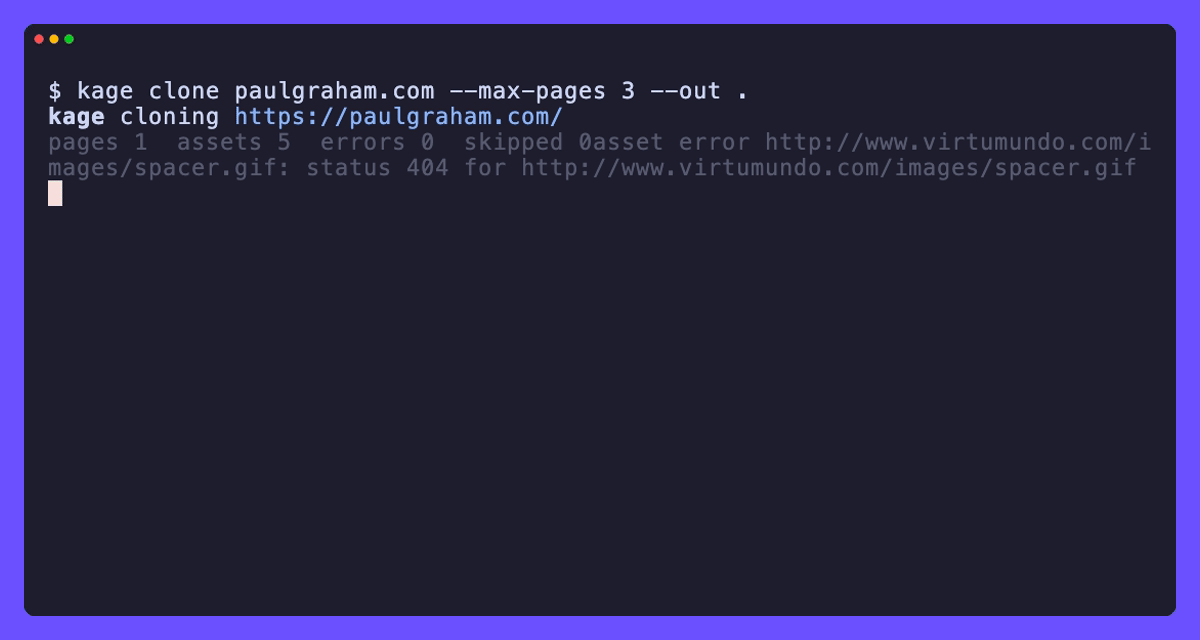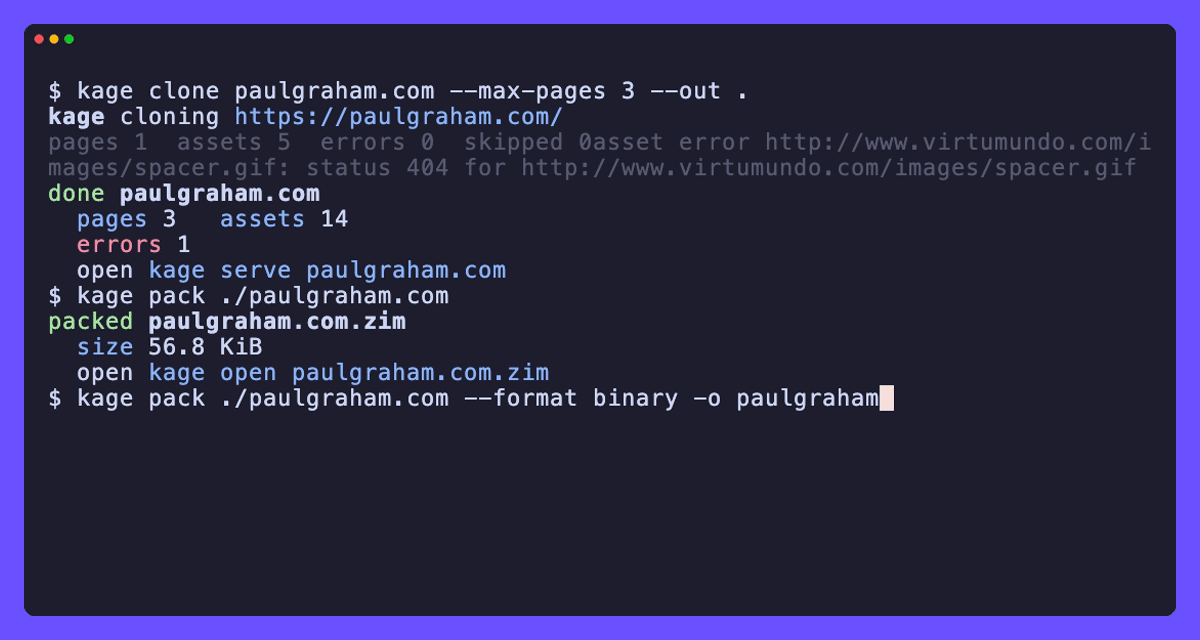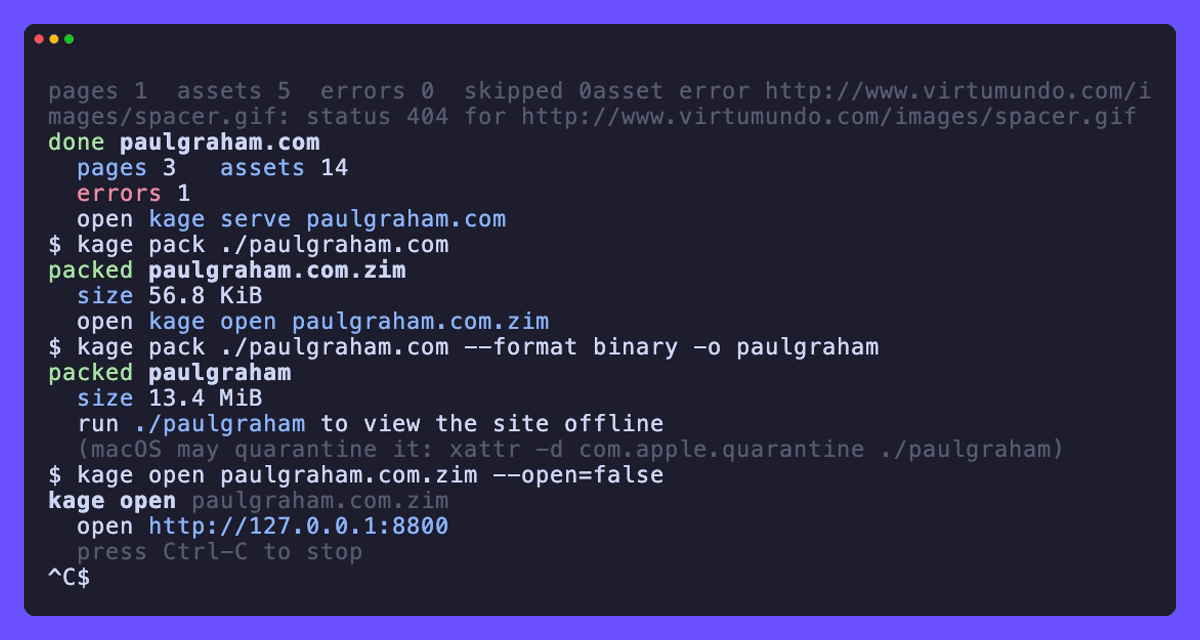
演示依照本文记录下来的 clone、pack 和 serve 工作流程展开,同时展示了结果网站在不连接原始在线站点的情况下运行。 来源及署名:github.com。
为了便于传输并实现长期访问,Kage 可以写入 ZIM 归档;ZIM 是 Kiwix 离线内容生态系统所采用的一种格式。仓库称,文本使用 Zstandard 压缩,而媒体不会经过这一压缩步骤。文档还表示,同一归档可以通过 Kiwix 工具或应用打开,但 Kage 不会创建某些 Kiwix 归档所附带的全 文搜索索引。因此,即使应用内搜索不如专为搜索而构建的归档,导航功能仍可能保持可用。
另一种打包方式是把归档附加到 Kage 可执行文件上,生成一个单独的文件;无需安装 Kage、ZIM 阅读器或其他软件,即可通过该文件提供网站内容。代价是文件体积:仓库估计,仅查看器本身就约需 13 MiB,尚未计入网站内容。可选构建可以通过各平台的 WebView 在原生窗口中打开结果,而默认纯 Go 构建则会打开系统浏览器。这些是项目文档记载的实现选择,并不构成对任何操作系统或未来浏览器版本的独立保证。
截图展示了本文介绍的可选自包含可执行文件和原生 WebView 查看方式。
必须准确理解移除脚本这一说法。所给仓库描述的是从捕获结果中剥离 JavaScript,并将链接资源本地化;它并不能证明所有网站都能得到忠实保存。表单、身份验证、流媒体、依赖服务器的操作、嵌入的第三方内容,以及需要实时 API 的功能,都可能缺失、受损,或仅保留到最后一次渲染的状态。因此,快照可以保存外观和可读内容,却无法保留原始应用的行为方式。
现有证据也没有说明 Kage 如何处理版权、服务条款、付费墙、私人数据或网站特有的访问控制。文档中的抓取设置描述的是技术行为,并不等同于法律许可。读者应把该工具视为制作其有权访问之材料的授权副本的方法,并另行评估每个来源所附带的规则。
Kage 最有价值、且在文档中得到充分说明的构想是分离:让真实浏览器生成可见页面,然后保留一个不再依赖原网站 JavaScript 的静态表示。它的局限同样重要。归档记录的是特定时刻、在既定配置边界内完成的抓取,无法证明动态内容、隐藏状态或网站未来版本已经被捕获。对于合适的网站,这可以成为离线阅读的实用途径;但对于完整的网络应用,它只是快照,而不是能够正常工作的复制品。