Transformer Explainer 从一个实际问题开始:文本模型如何在生成一个词元时,仍然把此前的词元纳入考量?答案并不是把整段对话压缩成一份固定的摘要。在该页面展示的仅解码器 GPT 风格架构中,每个词元都保有自己的表示;在模型预测下一词元之前,各层会反复在这些表示之间交换并转换信息。
第一阶段会把提示词转换成网络能够处理的数字。分词器将文本切分为词或子词;每个词元都会获得一个嵌入向量,位置编码则会补充它在序列中所处位置的信息。对于 Explainer 所采用的 GPT-2 small 模型,页面介绍了包含 50,257 个词元的词表、维度为 768 的词元向量,以及 12 个堆叠的 Transformer 模块。这些只是这个教学模型的属性,并非所有现代语言模型共同遵循的固定参数。
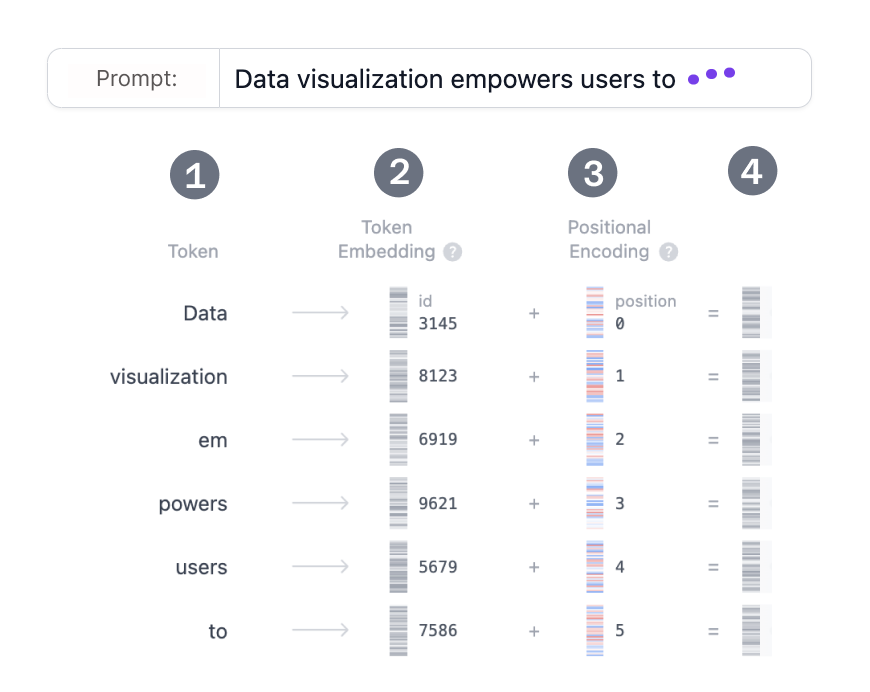
位于对分词、嵌入向量、位置编码以及 GPT-2 模型维度的说明之后。
在每个模块内部,多头自注意力让一个词元的表示能够融入其他词元的信息。模型利用学习得到的权重生成查询向量、键向量和值向量。查询向量与键向量的比较会产生注意力分数;因果掩码会阻止解码器在预测当前下一词元时使用未来词元;softmax 会把经过缩放的分数转换为权重;随后,值向量的加权和会被继续传递。多个注意力头会把向量划分到不同子空间中,从而学习不同类型的关系。不过,页面使用的网络搜索类比不应被误认为是对任何一个特定注意力头实际含义的直接描述。
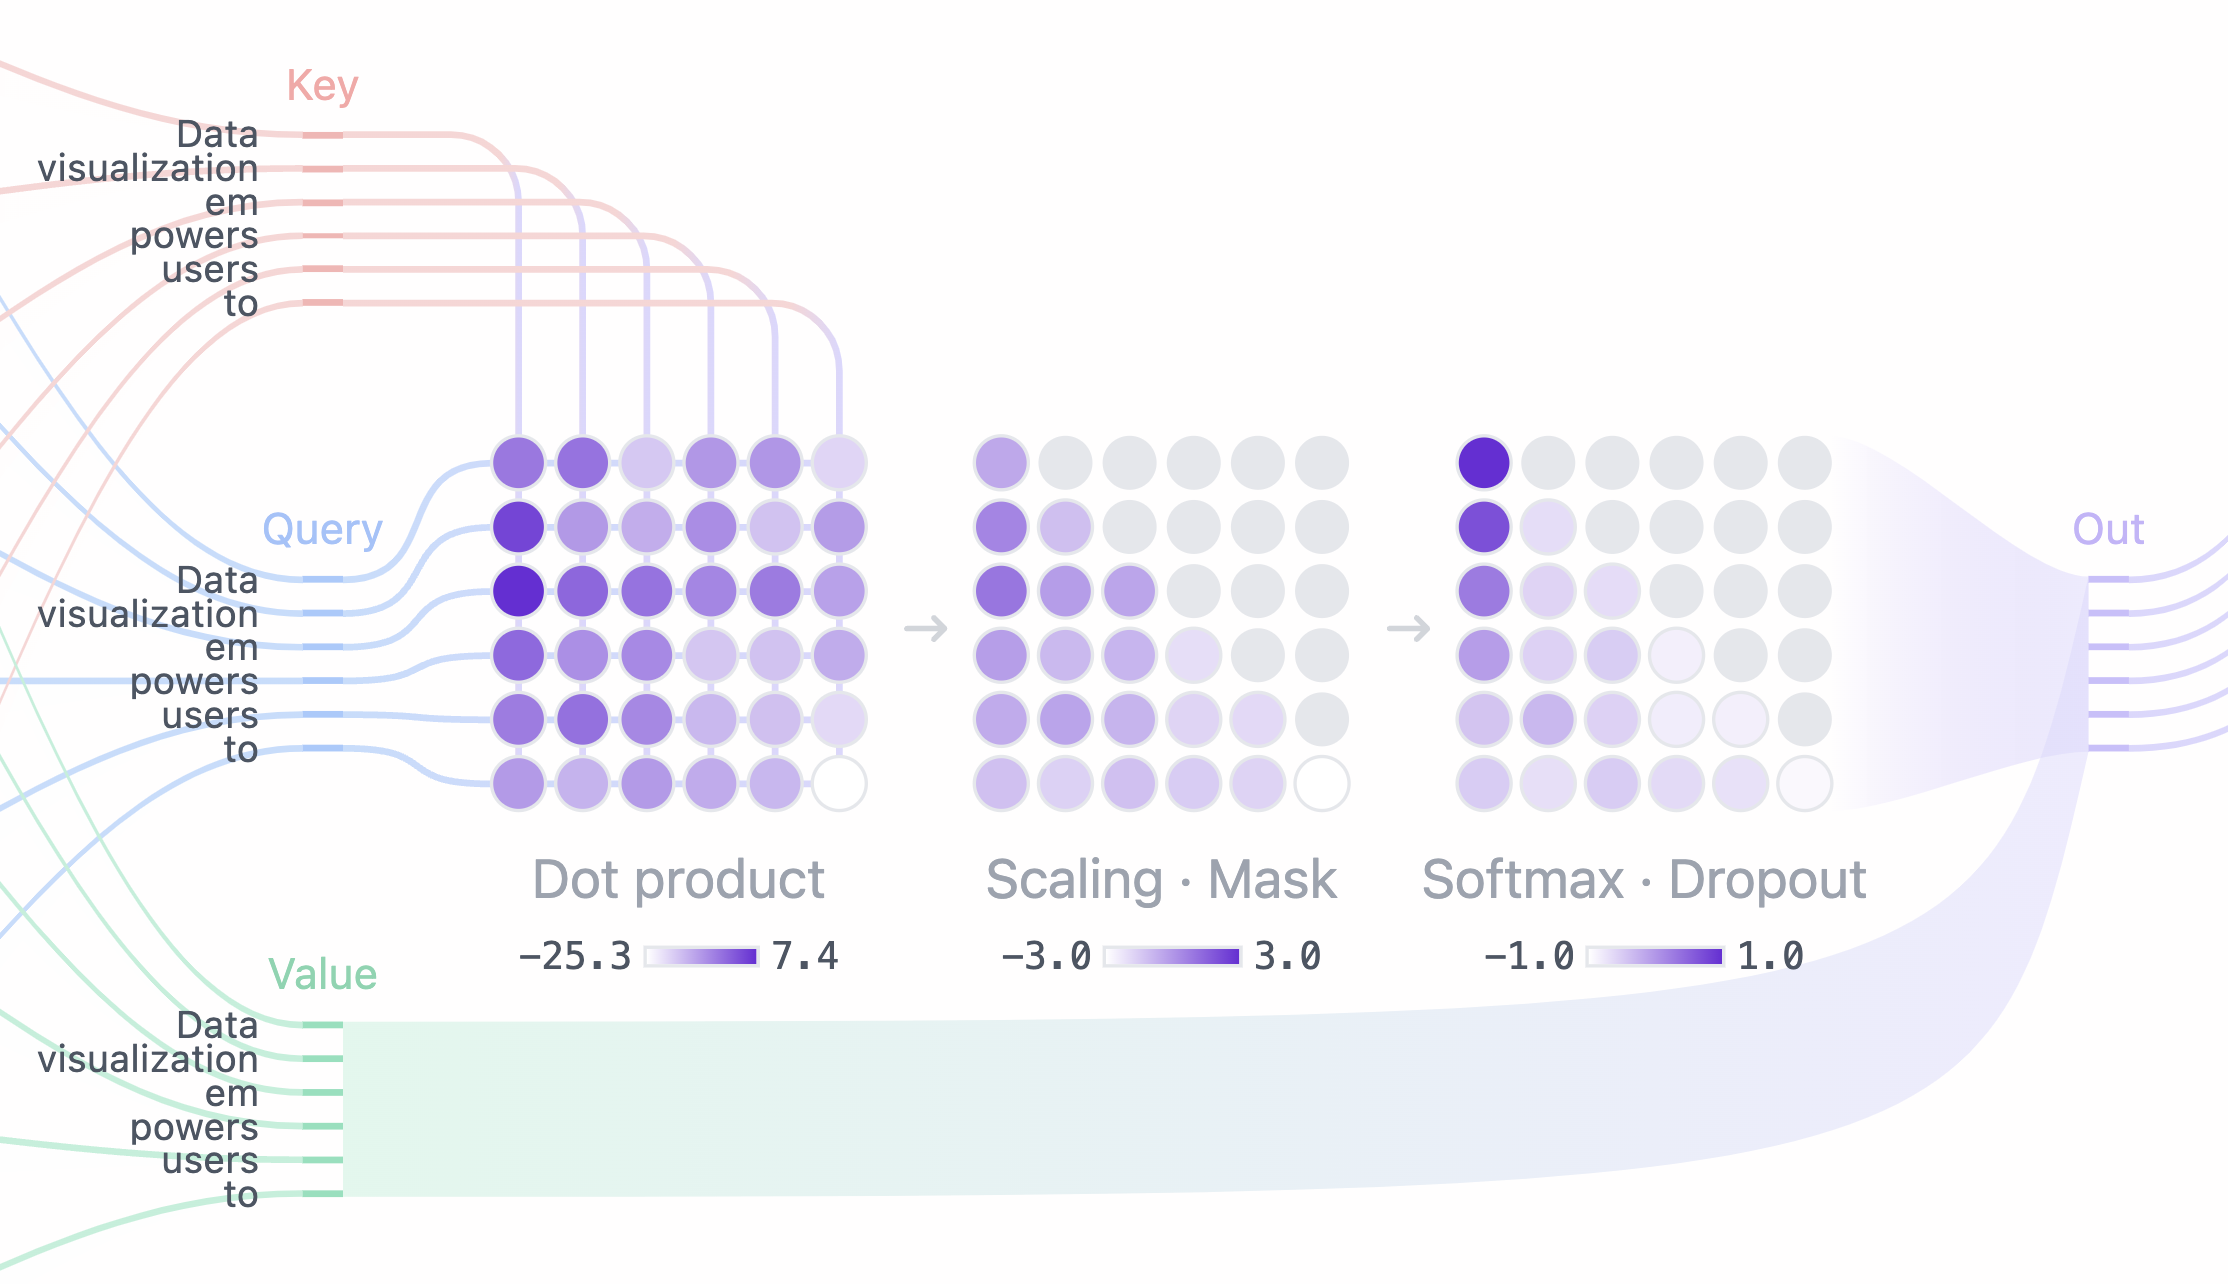
位于对查询向量、键向量、值向量、因果掩码、注意力权重以及多个注意力头的说明之后。
注意力只是 Explainer 所述标准模块的一半。注意力层的输出还会经过一个多层感知机,也就是 MLP;它会独立地对每个词元表示执行学习得到的转换。在 GPT-2 示例中,每个维度为 768 的表示会先扩展到 3,072 维,再应用 GELU 非线性函数,最后投影回 768 维。注意力操作与 MLP 操作交替进行至关重要:模型可以先把从其他位置收集到的信息在局部进行转换,再将其提供给后续的注意力层。正是这种反复混合意味着,某一时点看似扁平的向量并不表示模型已经永久丢弃其余上下文。
经过最后一个模块后,线性层会为词表中的每个词元生成一个逻辑值,softmax 再将这些逻辑值转换成概率分布。采样会选出下一词元,随后把它追加到序列中,整个过程便继续下去。温度参数会改变概率分布的尖锐程度,而 top-k 采样和 top-p 采样则会限制候选词元集合。这些控制项会影响输出结果的可预测性和多样性;它们本身并不能证明输出是安全的、真实的或富有创造力的。
一项有用的界限属于架构层面,而不是外观层面。Hugging Face 的技术文档区分了最初的编码器—解码器 Transformer、仅编码器模型(如 BERT)以及仅解码器模型(如 GPT-2)。文档还说明,音频 Transformer 通常会增加输入适配器:卷积特征编码器可以先把波形或语谱图转换成嵌入序列,再由 Transformer 处理。这进一步支持了一个更广泛的观点:“Transformer”指的是一类可复用的架构家族,其输入、掩码和输出头会随任务而变化。它并不能证明每一种音频或语言系统都采用演示中可视化的那套与 GPT-2 完全相同的处理流程。
这个交互页面的代码仓库将该软件说明为一个在浏览器中运行实时 GPT-2 模型的学习工具,并把它与一篇发表于 2026 年 CHI 的论文关联起来。因此,该代码仓库能够佐证项目的具体实现和作者信息,却不能独立证明这种可视化是最清晰的解释方式,也不能证明其中的类比普遍成立。同样,Explainer 对注意力作用的说明只是对演示架构的描述,并非关于每一种 Transformer 注意力头内部所学概念的实验性证据。
对于试图理解语言模型的读者,最有效的思维模型是一连串上下文相关的转换,而不是在一篇被压缩的段落中进行搜索。注意力决定各层如何组合词元表示;MLP 对这些表示进行转换;残差连接和归一化有助于堆叠计算顺利训练;输出层则把最终表示转换成下一词元概率。单个权重或注意力头所学到的确切作用仍然取决于具体模型和任务,因此,这套可视化能够解释计算过程,却无法完整解释为什么某个特定模型会给出某个特定答案。