小米推出了 MiMo-V2.6 系列:包括原生多模态的 Pro 和 Flash 模型,以及公司称正在推出的 Pro-UltraSpeed 模型。VentureBeat 在 9 月 21 日报道了此次发布,并将 Pro 模型描述为开放权重领域的基准测试领先者,而非超越所有闭源模型的模型。
最引人注目的数据是关于训练效率的。小米表示,每个模型在不到六天的时间内,完成了跨越约 750,000 条轨迹的 30 个强化学习步骤。公司报告 Flash 模型的训练成本约为 85 万美元,Pro 模型约为 262 万美元。这些是小米提供的数据;提供的原始文章和 VentureBeat 的报道并未建立独立的复现或验证。
小米还报告了显著的 DeepSWE v1.1 提升:Flash 从 48.8 上升到 65.68,而 Pro 从 58.4 上升到 72.57。这些结果应被视为公司报告的基准测试结果,而非独立复现的评估。官方文章列出 Pro 模型的 Artificial Analysis Intelligence Index 得分为 46.32,并承认与最强的闭源模型之间仍存在差距。
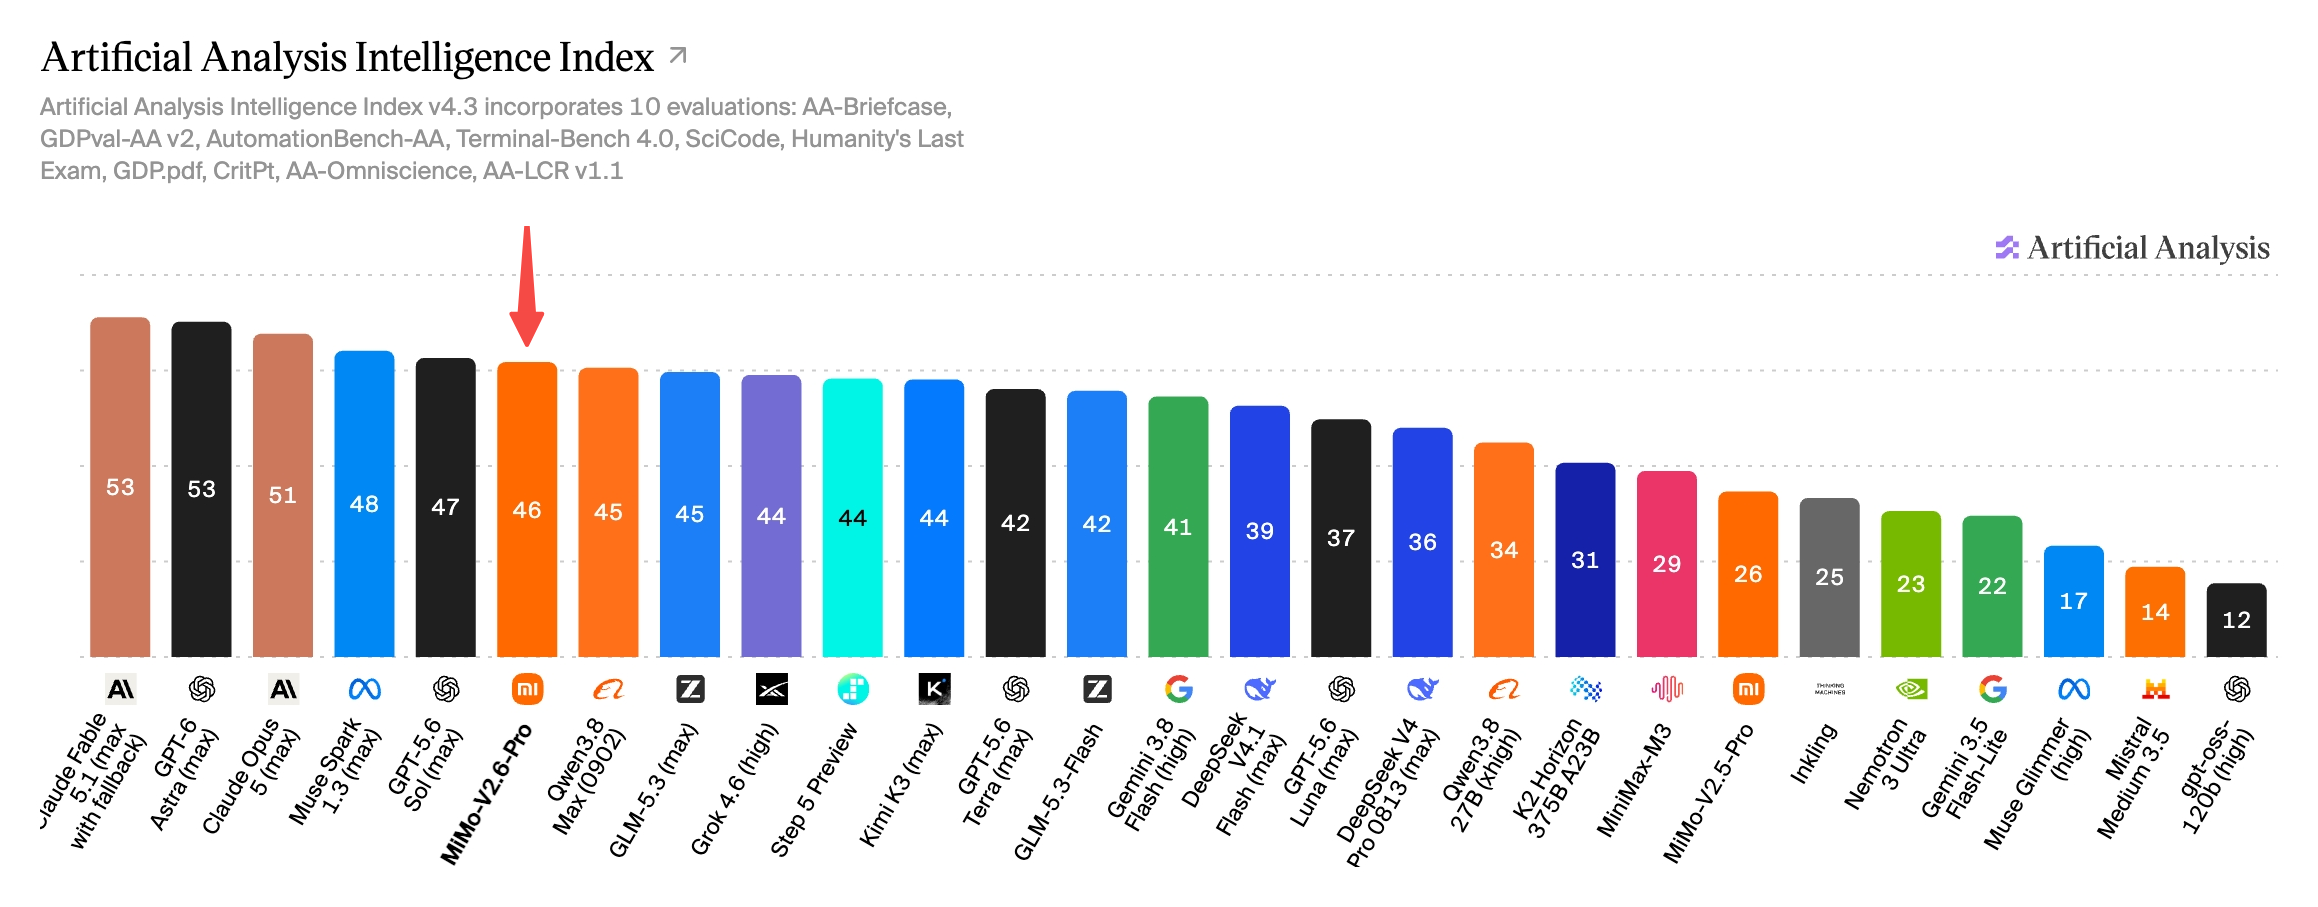
该分数由公司发布,应结合文章中的注意事项来阅读,即任务排名各异且某些闭源模型仍处于领先地位。
这一限定条件非常重要。VentureBeat 指出,一些闭源模型的评估仍处于领先地位,且排名会随任务而变化。因此,提供的证据支持一个更窄的结论:MiMo-V2.6 Pro 在选定的开放权重基准测试中表现出竞争力,而非在所有 AI 工作负载中都具有普遍优越性。
小米表示将发布模型权重、技术报告、超过 7,000 个强化学习任务环境、一个端到端的 RL 框架以及 MiMo-V2.6-Distill-Qwen-9B。如果这些材料如描述的那样可访问且可用,它们可以帮助研究人员检查训练方法并复现更多工作。该资料包并未确认下载可用性、许可条款或对产出物的独立验证。
这一公告之所以重要,是因为较低的报告训练成本和发布的架构可能会扩大那些预算有限的组织之外的实验范围。尽管如此,来源资料仅确立了小米宣布的内容以及 VentureBeat 报道的内容;它并未证明效率声明或基准测试的提升已得到独立确认。