M5 Ultra Mac Studio 是 Apple 的高端台式机,由两颗 M5 Max 芯片连接成一个系统。在为期四天的评测中,MacStories 测试了一台配备 256GB 内存的机型,用于运行本地人工智能智能体——这类软件能够串联推理步骤并调用工具,而不只是回答单个提示。作者的核心观点是,更快的提示处理和文本生成,让本地模型在反复执行、长时间运行的任务中显得更实用。
文章开头介绍了 M5 Ultra Mac Studio 及其本地 AI 工作负载,包括评测中用于生成图像的本地图像生成。
关键在于运行机制,而不只是芯片名称。智能体开始一轮处理时,必须先解析其指令、记忆、工具描述和此前的对话,然后才能生成输出;这段等待称为 token 预填充。随后的生成速度则决定回复出现的快慢。评测者报告称,与 M3 Ultra 相比,M5 Ultra 平均将生成时间缩短约 70%,并将提示处理速度最高提升 150%,即约 2.5 倍。在一种配置中,Qwen3.8-Flash-Next 在短提示下超过每秒 100 个 token,在 64K–256K 上下文下仍保持在每秒 60–85 个 token。
这些结果来自评测者本人将其与 M3 Ultra 以及一台装有 Nvidia GeForce RTX 5090 的台式机进行的比较;后者是面向消费者的图形处理器,配备 32GB 显存。Nvidia 产品页面将 RTX 5090 描述为基于 Blackwell 架构、面向高要求创意和 AI 工作负载的 GPU。不过,MacStories 发现 RTX 5090 在显存带宽方面仍占优势,而 Mac Studio 体积更小、更安静,也更容易保持数据本地化。这一比较仅具说明意义,并非适用于所有情况的排名:两台设备在内存、软件和工作负载配置上均存在差异。
评测中最具体的例子是 Desk,这是一款内部研究应用,曾连续 99 天使用本地智能体整理 310 份文档、从网页和 PDF 中提取信息、交叉引用笔记并更新 Notion 数据库。作者表示,这避免了云端 API 费用,并将数据保留在他所控制的设备上。这解释了它在持续性工作负载中的吸引力,但这只是一个人的工作流,并非对开发者生产力或总体拥有成本的受控研究。
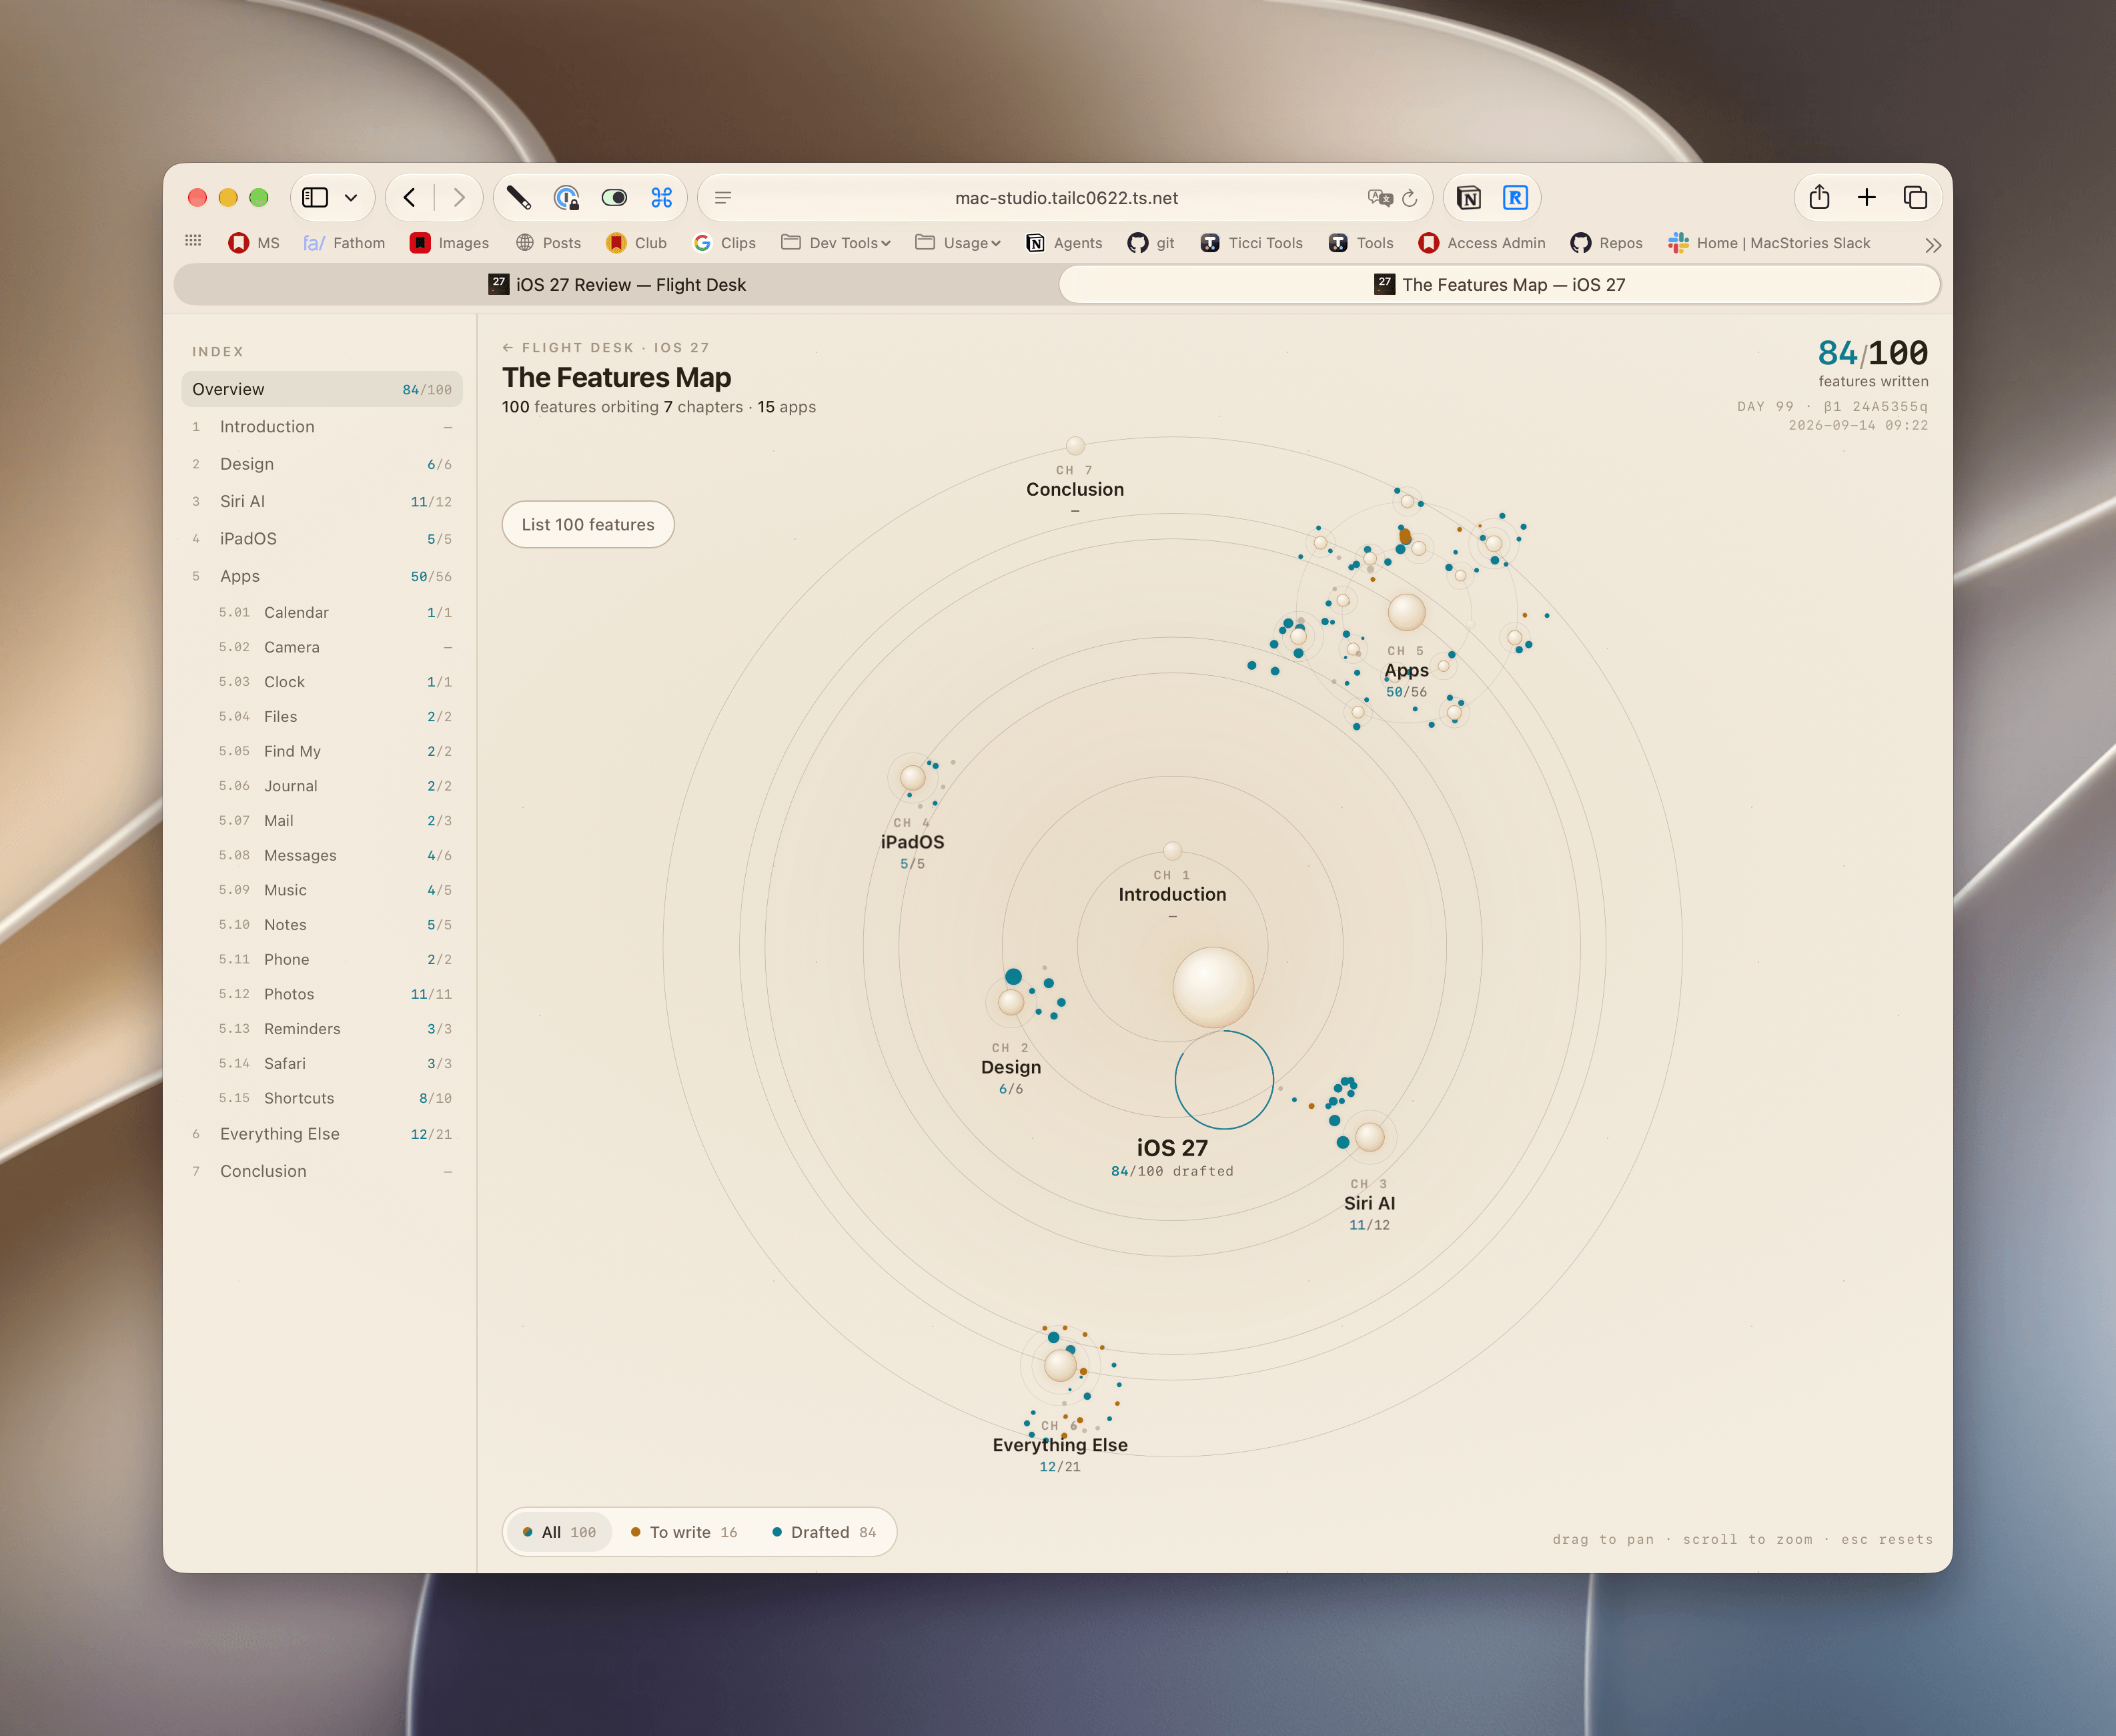
文章中的具体工作流示例是 Desk,它使用本地智能体整理文档、提取信息、交叉引用笔记并更新 Notion。
此外还有容量方面的限制。MacStories 表示,受测设备拥有 256GB 内存;MacRumors 论坛的一则报道援引 Apple 的说法称,512GB 配置预计将在 10 月下旬推出,价格将超过 10,000 美元。所供资料包不包含 Apple 的完整规格,也没有独立基准测试,而且无法说明较低比特的模型量化——通过压缩模型来减少内存占用——会如何改变回答质量。因此,目前能够稳妥得出的结论更为有限:对这位评测者而言,M5 Ultra 让本地智能体明显更快、更可用,而更广泛的性能、质量和经济性比较仍有待验证。