根据所附帖子,Fable 5 是 Anthropic 推出的一款模型,可通过订阅方案使用。核心说法并不是已经证明其底层权重发生了改变,而是用户可能获得不同的推理配置——即回答提示词时使用的计算额度和推理过程。Lon Lundgren 报告称,在 Fable 5 转为永久可用后,8 月的调用通过五种测量方法测得的“思考令牌”都明显少于 7 月。“思考令牌”是模型用于输出推理内容的令牌;数量减少可能意味着模型在给出最终答案前进行的内部思考更少。
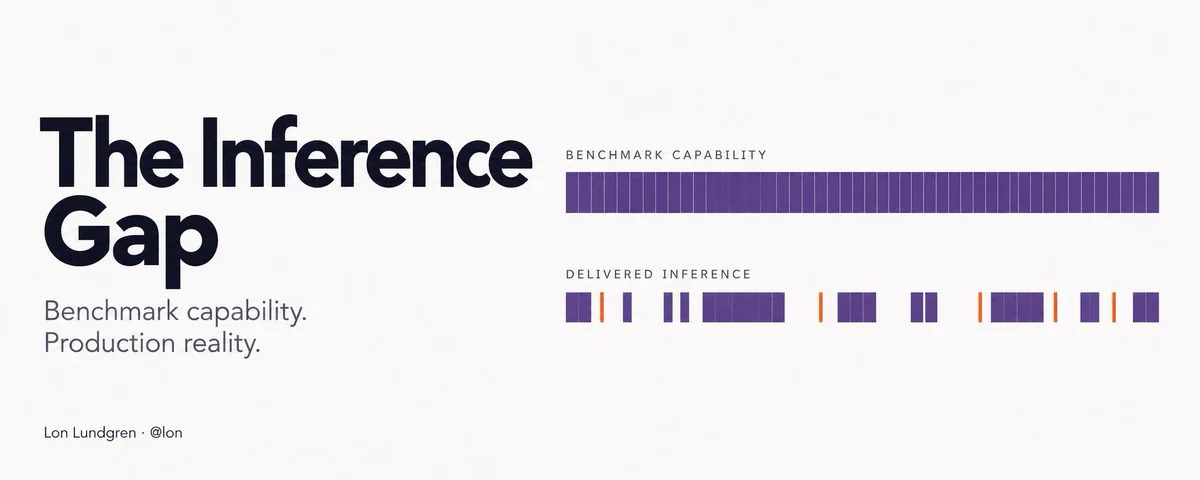
Lundgren 的帖子是本文报告的主要来源;该报告称,8 月调用通过五种测量方法测得的思考令牌少于 7 月。
该帖子称,这一模式持续了六周,期间存在跨日波动,其中一些变化与产品公告或发布相吻合。Lundgren 还报告称,大多数请求几乎没有或完全没有思考,即使界面显示请求的是 xhigh 或 max 努力程度;较长时间的运行也很少达到已发布基准测试的水平。这有助于解释为什么同一款模型可能今天显得有能力、明天却表现较弱:可见的模型名称可能保持不变,而实际提供服务的推理配置已经改变。
读者关心的一个关键问题是,这是否能证明有人刻意“削弱”了模型。答案是否定的。原始来源只能确立 Lundgren 的测量结果及其解读,不能证明 Anthropic 的意图、计算资源分配变化的原因,也不能说明所有用户是否经历了相同的模式。所附材料还缺少底层数据集、五种测量方法的定义,以及与 Anthropic 自有基准测试协议的直接比较。
Marginlab 的独立追踪器仅能作为如何监测模型性能的背景参考。该追踪器称,它在一个经过筛选的 SWE-Bench-Pro 子集上对使用 Opus 5.0 的 Claude Code 进行基准测试,每天进行 50 次评估,并使用规模更大的每周和每月样本,以检测具有统计显著性的变化。其页面称,基线数据仍在收集中,性能下降检测处于暂停状态,因此它既没有佐证有关 Fable 5 的说法,也没有证明其他模型受到同样问题的影响。
对订阅者而言,实际后果是不确定性:稳定的输出质量可能不仅取决于选择了哪款模型,还取决于实际提供的推理预算。目前尚不清楚 8 月所报告的下降是暂时现象、与负载有关、由政策驱动,还是与某项特定产品变化相关。仅依据这组材料,能够稳妥得出的结论是:Lundgren 观察到推理令牌使用量大幅减少,但其原因和更广泛的存在范围仍未得到验证。