DataHaskell 组织通过在其数据帧库中实现原生 Parquet 写入器,扩展了其数据科学工具包。Parquet 是一种广泛使用的列式存储格式,针对高效的数据检索和压缩进行了优化,使其成为现代数据科学工具之间互操作性的标准。此前,Haskell 开发人员主要局限于 CSV 或 JSON 等格式,这些格式往往存在性能限制,且缺乏大规模数据分析所需的结构化元数据。通过启用原生 Parquet 支持,该库允许用户使用简单的接口直接将数据帧写入磁盘,同时提供高级配置选项,以便针对特定工作负载微调行组和页面大小。该实现使用固定字节数组来管理内存,以处理数据在刷新到磁盘前的缓冲复杂性,确保写入器能够适应不同的数据结构。虽然当前版本支持基本的平面模式和 Snappy 等必要的压缩编解码器,但它仍是一个单线程实现,未来计划解决内存限制并增加对更复杂嵌套数据结构的支持。这一进展标志着 Haskell 向成为更实用、更高效的数据密集型任务选项迈出了一步,使其在更广泛的数据科学生态系统中更具竞争力。
HN Digest / · HN #49802510
为 Haskell 数据科学生态系统实现 Parquet 文件写入器
DataHaskell 项目为其数据帧库引入了原生的 Parquet 写入器,使 Haskell 用户能够将数据序列化为行业标准的列式存储格式,从而提高互操作性和存储效率。
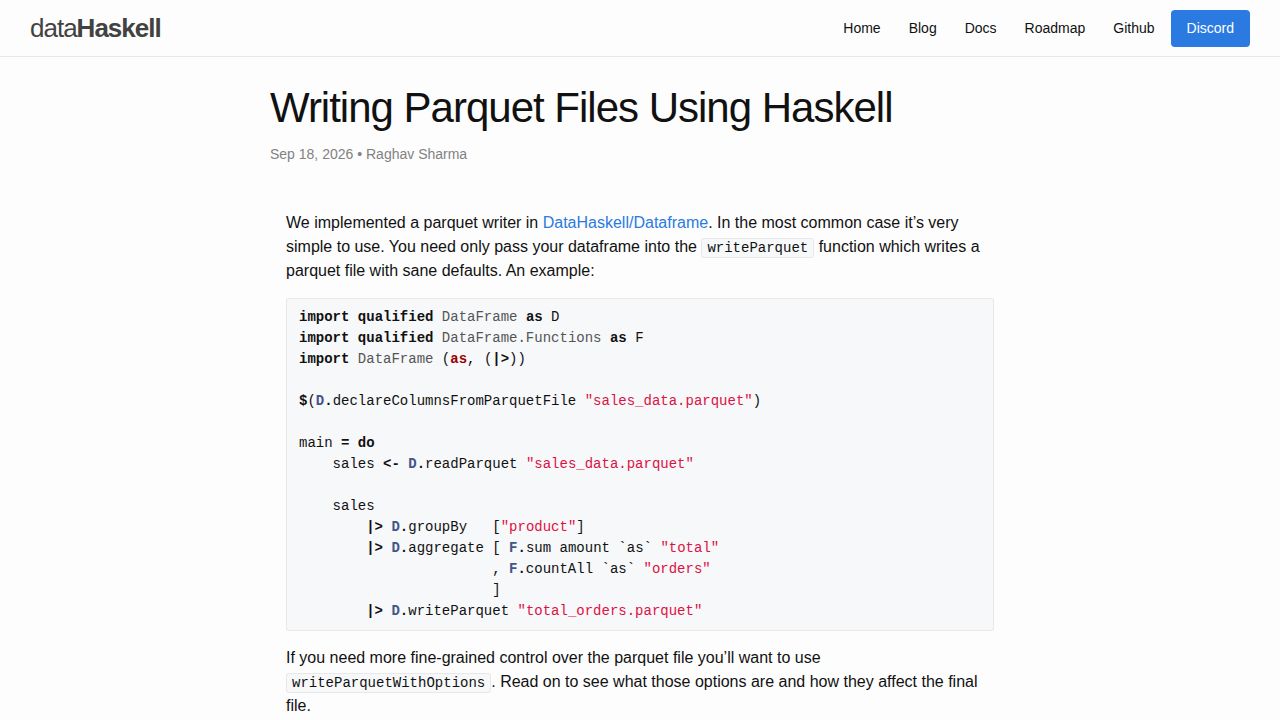
来源页面截图(datahaskell.org)