最近一篇文章提出,机器学习智能正变得如此廉价,以至于消耗的 token 数量可能很快不再像输出质量和可访问性那么重要。token 是文本中的一个小单位;这篇文章大致按每个英文单词 1.5 个 token 计算。它区分了原始 token 价格与完成每个任务的成本,因为较小的模型有时会在思考或自我纠错时消耗更多 token。
核心机制并不是某一项突破。作者综合了图形处理器(GPU)效率提升、推理软件改进,以及每次请求只激活更少参数的模型设计。以混合专家模型为例,这类模型会把任务路由给选定的专家组件,而不是运行网络的每一部分。该文章估计,过去一年 token 成本下降了约 2.5 个数量级,其中包括每个任务的成本效率提升约 100 倍、硬件能源效率提升约 1.3 倍,以及推理引擎效率提升约 1.4 倍。
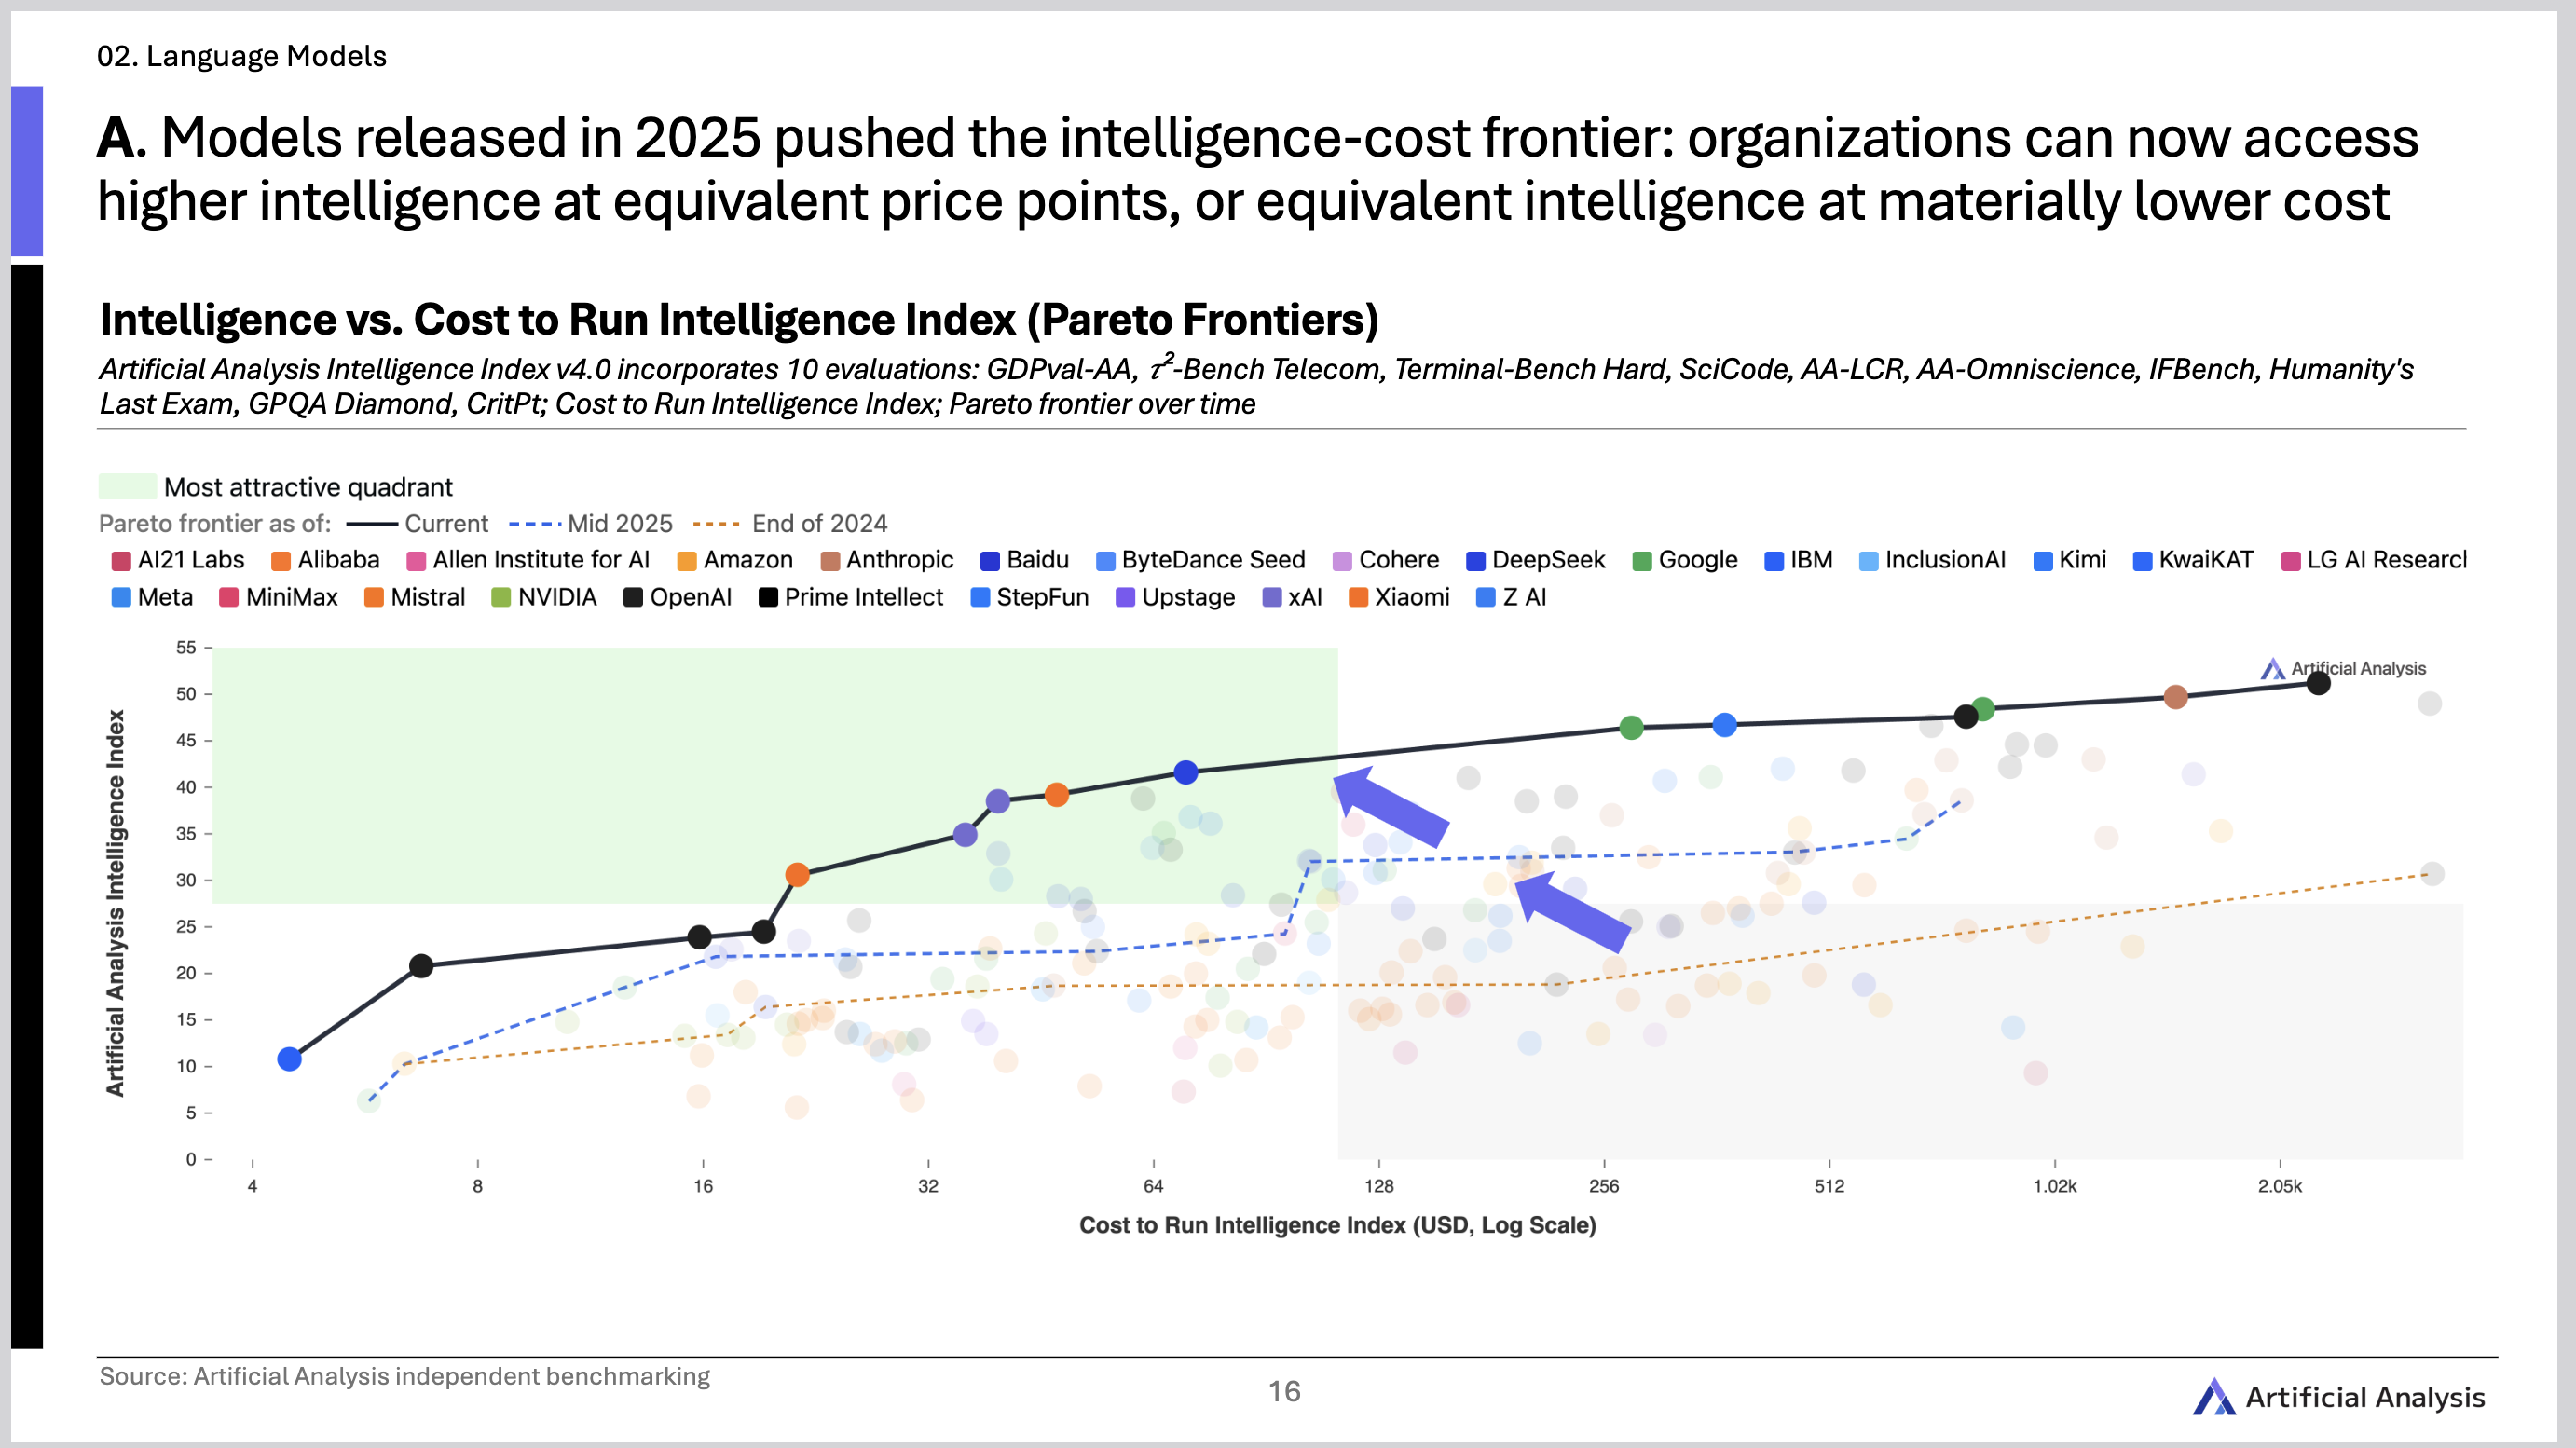
置于文章解释 token 成本的实际下降,以及衡量方式从原始 token 价格转向完成每个任务的成本之后。
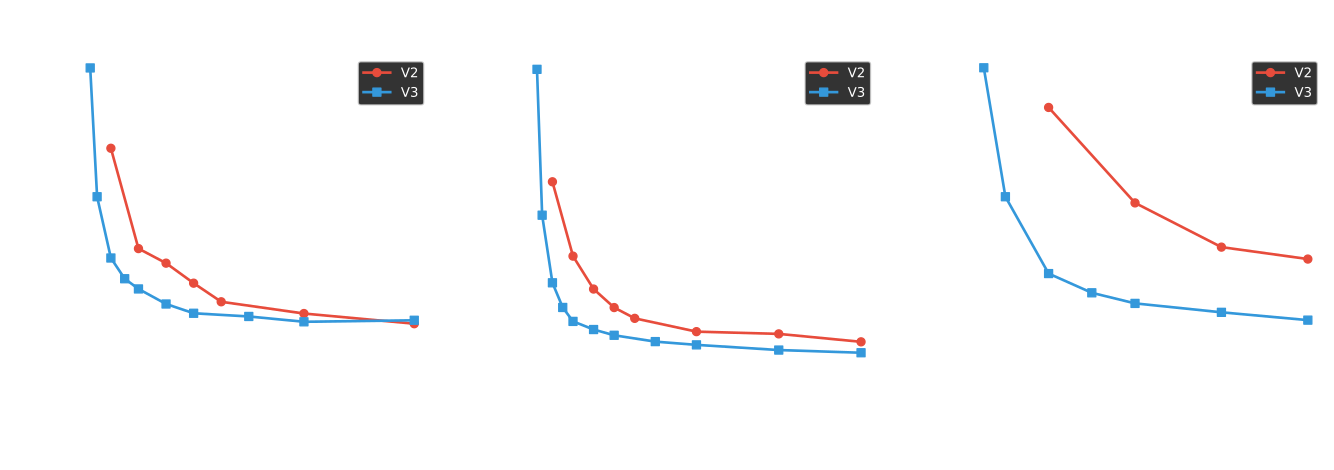
置于文章指出 GPU 效率、推理软件和模型设计是降低推理成本的独立机制之后。
所附的模型页面展示了这种架构转变。Muse Glimmer 是一个拥有 300 亿参数的本地模型,其发布者称,4 位量化可将其压缩到 20GB 以下,从而可在 24GB 或 32GB 的内存范围内运行。Qwen3-Coder-30B-A3B-Instruct 总共有 305 亿个参数,但每次请求只激活 33 亿个参数,同时使用 128 个专家中的 8 个;它原生支持 262,144 个 token 的上下文,并可通过 Yarn 扩展到 100 万个。这些是发布者提供的规格,并非对普通用户实际表现的独立证明。
文章认为,如果推理变得足够便宜,模型可能会进入普通工具内部,而不是继续作为独立的聊天产品存在。粗略比较显示,一次模型交互的成本仍比 grep、解析 HTML 或构建代码等命令的电力成本高出几个数量级。这样一来,在完整对话式界面会造成浪费的场景中,AI 辅助过滤、调度或分流就会变得切实可行。不过,这一比较只是说明性的:它使用的是估算的 token 数量、本地功耗和电价,而不是一次受控的端到端基准测试。
最大的不确定性在于这一趋势能否延续。效率提升可能遇到硬件限制、软件瓶颈或收益递减,而成本下降也可能只是促使人们使用更耗费算力的应用。这份材料也没有任何独立成本研究来验证文章的综合预测。它所能支持的结论更窄:AI 技术栈的若干部分正在快速改进,它们的综合影响可能让某些模型调用便宜得惊人。至于这能否带来持久的经济价值,而不是仅仅增加使用量,仍未得到证明。