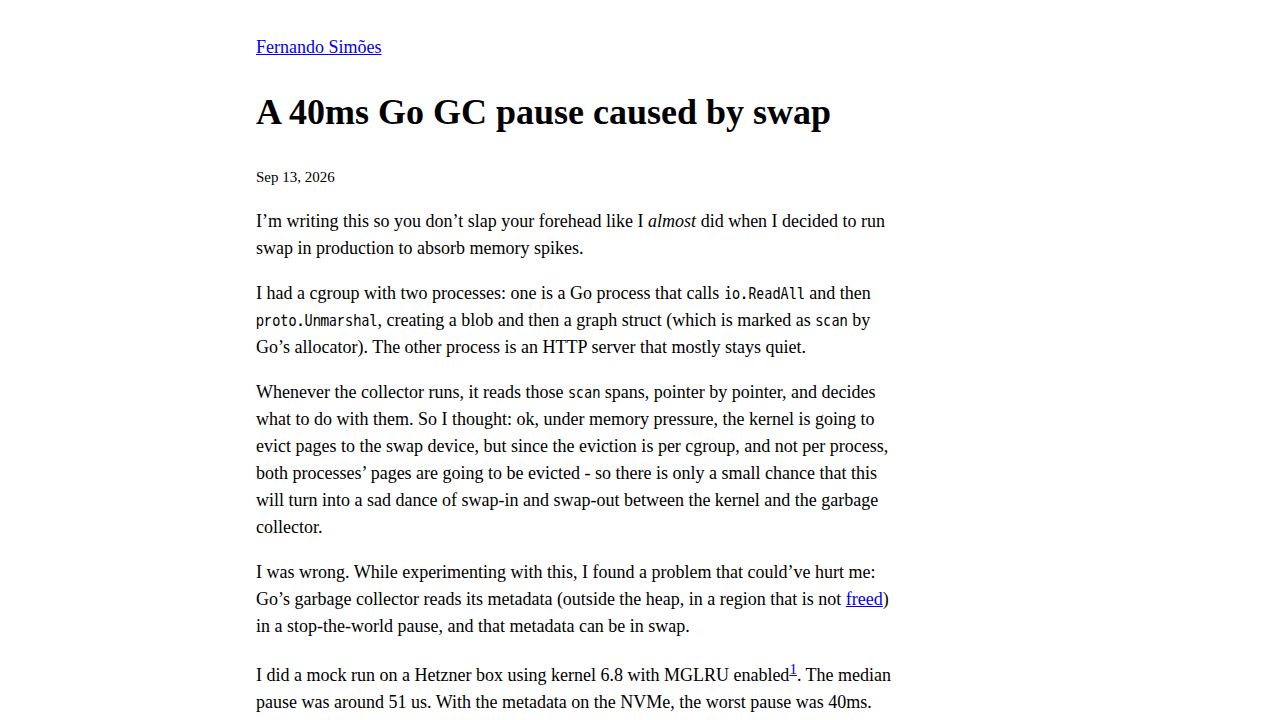
Fernando Simões 在 Go 生产服务中遇到了意外的 40ms 垃圾回收停顿,这促使他进行调查,发现交换使用是根本原因。 该问题出现在包含两个进程的 cgroup 中:一个 Go 应用程序执行 io.ReadAll 和 proto.Unmarshal 操作以创建 blob 和图结构,另一个是大部分空闲的 HTTP 服务器。 在垃圾回收期间,Go 运行时必须在停顿世界(stop-the-world)暂停期间读取位于堆外的其元数据结构。 Simões 发现,在内存压力下,内核基于 LRU 的页面置换算法将这些元数据页面移动到交换空间。 当垃圾回收器试图访问它们时,每个页面都会触发一次主要页面错误,要求内核读取页表项,调用 do_swap_page,分配一个新帧,将其计入 cgroup,读取页面内容,提交 bio 请求,等待磁盘 I/O 完成,并将页面恢复到内存中。 为了诊断问题,Simões 使用了 BPF 脚本来统计停顿世界事件期间的页面错误。 最坏情况下显示,40ms 停顿中有 39,902 微秒被页面错误消耗:228 次错误占用了 39,013 微秒用于错误处理。 addr2line 输出将这些错误追溯到 GC 记账函数,包括 runtime.(*spanSet).reset、runtime.finishsweep_m 和 runtime.gcStart.func2。 垃圾回收器在清理终止和标记终止点执行停顿世界暂停。 在一次 30 分钟的测试中,发生了 312 次此类暂停,其中 40ms 的延迟是内存中元数据保持时观察到的 51 微秒中位数暂停的 800 倍。 由于每个处理器(P)在这些暂停期间都会停止,任何等待 I/O 的 goroutine 可能会错过完成信号,导致下游延迟。 此外,Simões 注意到构建一个 511KiB 的消息在 NVMe 上从 3-5ms 增加到 105ms,在 Hetzner 的网络卷上增加到 903ms,尽管他无法确认此减速是否源自相同的交换机制。 使用 Go 1.26 的 Green Tea 垃圾回收器进行的更新测试显示对与交换相关的停顿问题影响可忽略不计。 这些实验(包括图表、模拟分配器、BPF 和 Python 脚本)可在 https://github.com/frnsimoes/go-gc-swap-cost 获得。 核心发现仍然是:交换和 Go 的垃圾回收器在低延迟工作负载下是不兼容的,因为操作系统级别的内存压力可能通过元数据分页导致无限制的停顿世界暂停。
HN Digest / · HN #49959654
可追溯至交换分页元数据的 40ms Go 垃圾回收停顿
一位 Go 开发者发现,当 GC 元数据被换出时,交换使用可能导致 40ms 的停顿世界垃圾回收停顿,揭示了生产系统中的潜在延迟风险。
来源页面截图(frn.sh)