Laurentiu Raducu 学习复杂主题的方法,始于一种熟悉的挫败感:语言模型给出的解释往往听起来清晰,却过于抽象,难以检验。他不再要求 LLM 提供又一份摘要,而是提出一套四步工作流:先让编程助手奠定主题的知识基础;再请模型审查这份知识库的准确性;随后把主题制作成小型低多边形模拟;最后发布成果,供他人检查和修订。这一方法通过 ChipTycoon 得到具体展示——这是一个解释芯片制造过程的交互式作品,沿着材料从采集砂石,到晶圆制造,再到交付数据中心的完整路径展开。
核心理念并不只是动画比文字更有吸引力。模拟会迫使学习者明确表达状态、转换、输入和输出。ChipTycoon 让一辆小车依次经过各个制造阶段,并随着流程推进改变车上的物品。这种设计能够暴露缺失的步骤或含糊不清的关系,而这些内容可能会被项目符号列表掩盖。它还让学习者拥有了可以具体追问的对象:如果某个阶段无法被表现出来,底层解释就可能需要修订。Raducu 指出的正是这种实际优势,不过,这篇文章没有提供实验证据,证明它能带来优于阅读或传统学习的记忆保持效果。
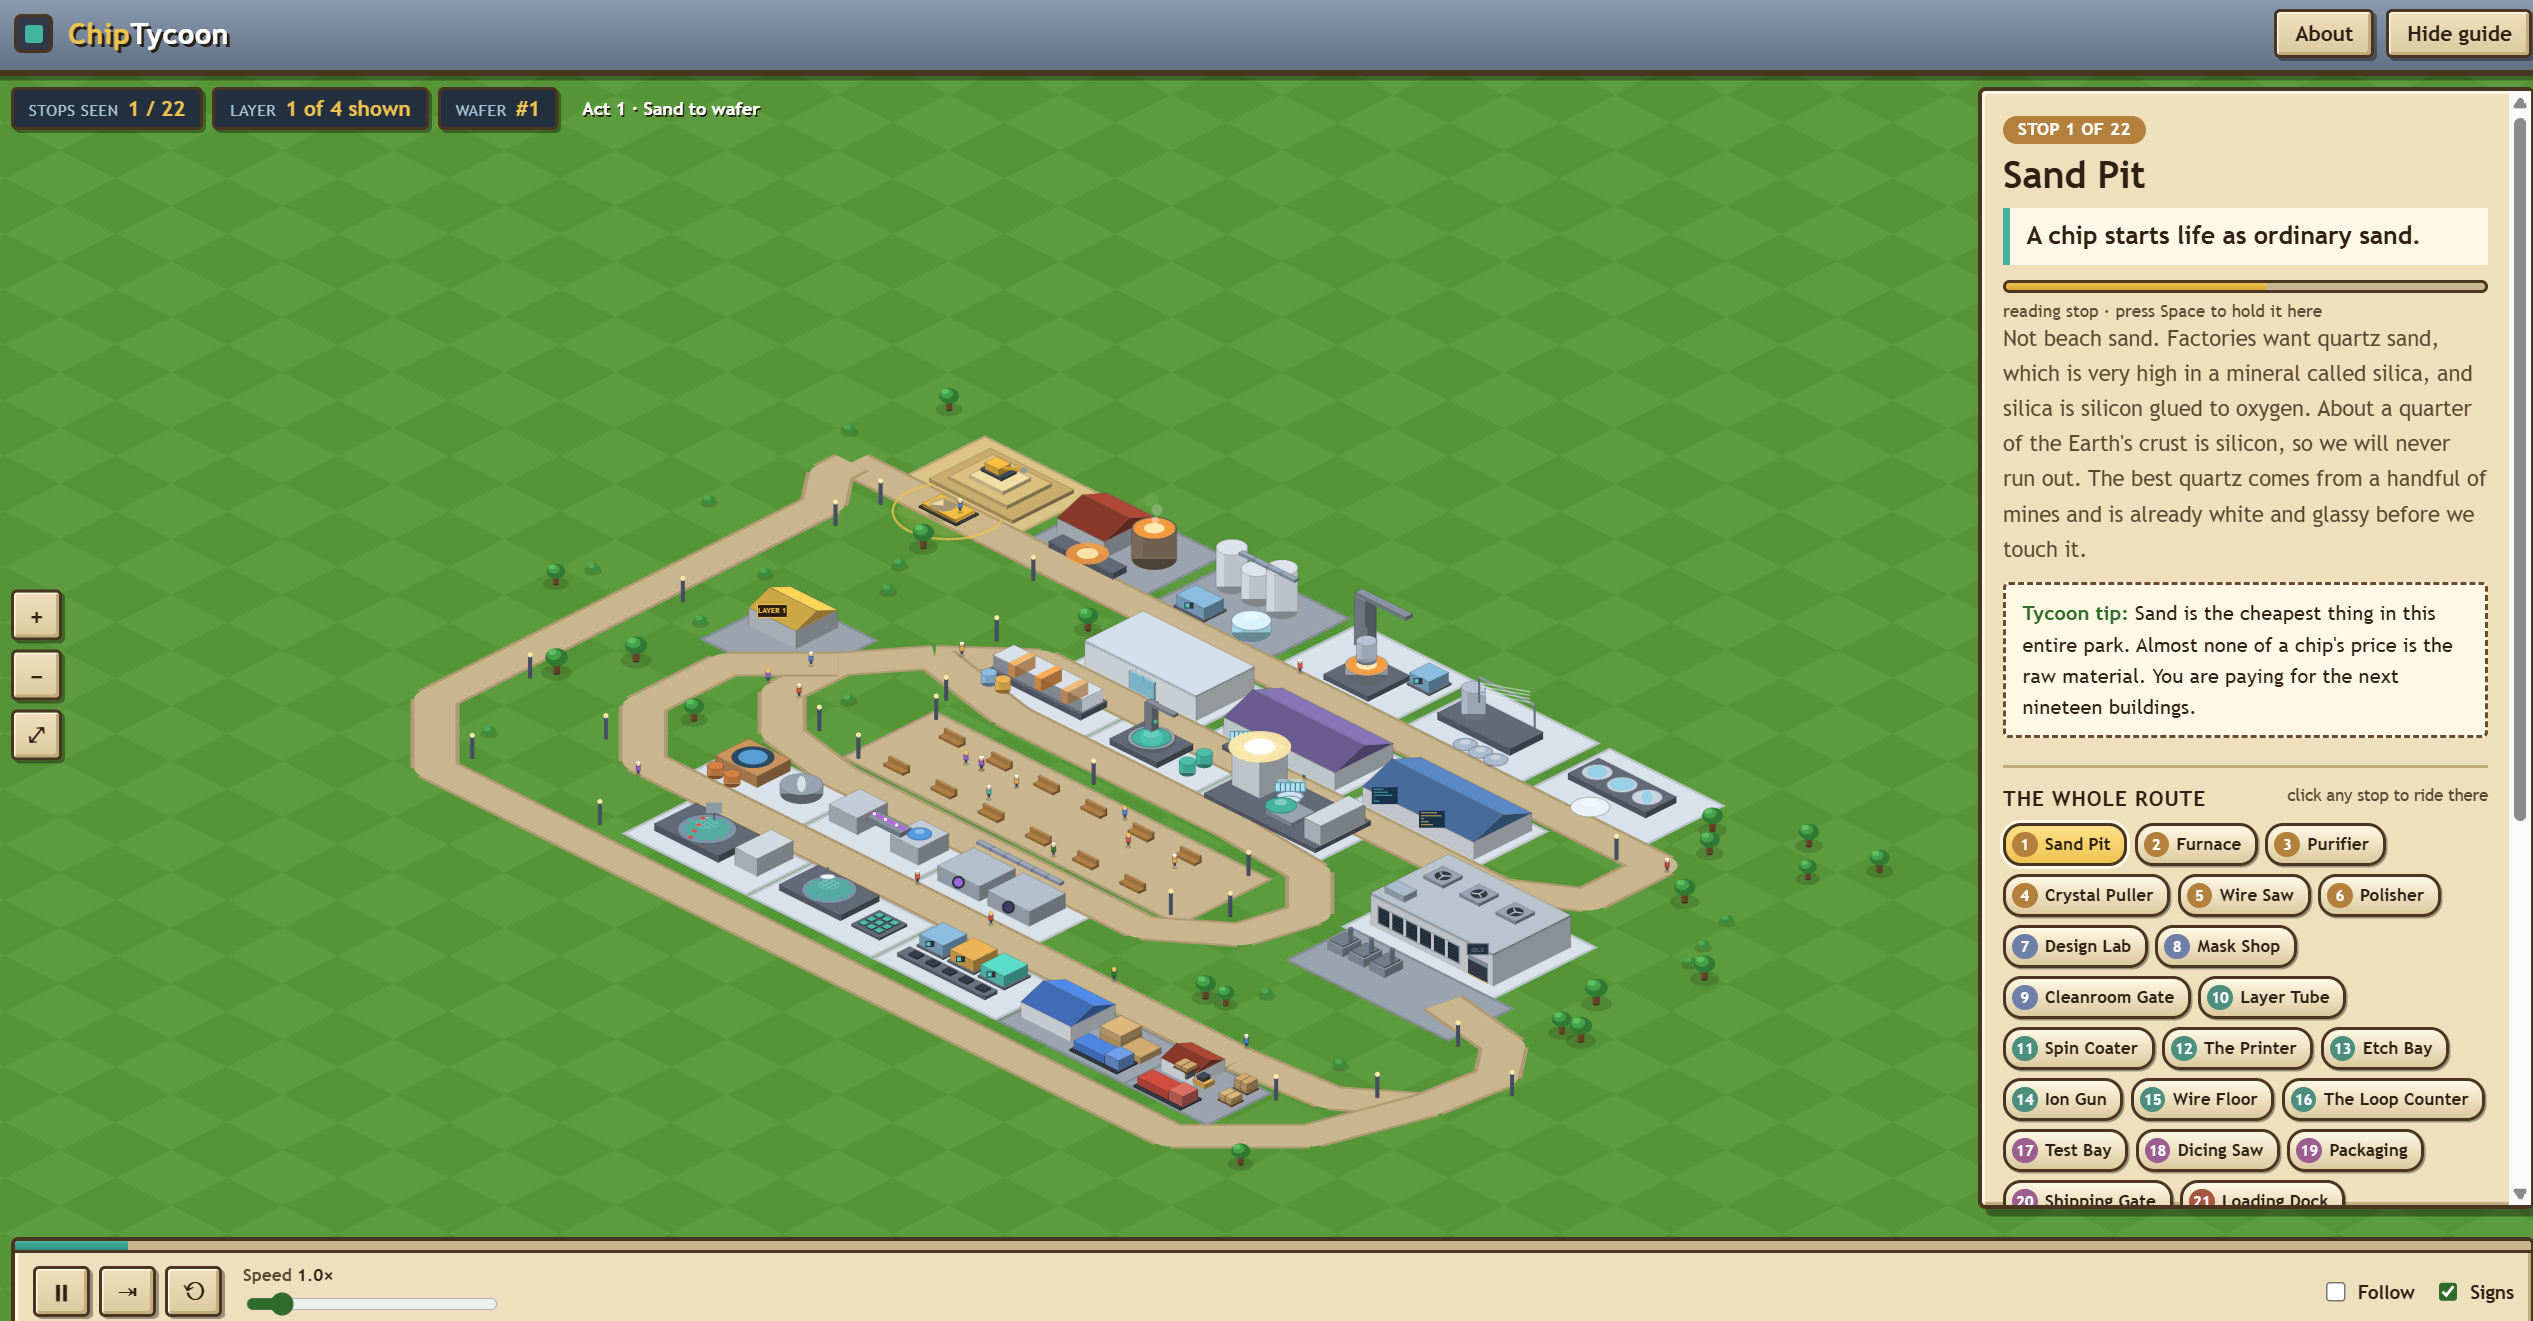
这张来源图片直接支持文章的解释:小车载运内容的变化,使各个制造阶段变得可见且可以检验。所给资料未说明这张图片的使用权;署名不构成使用许可。
这套工作流的第二步尤其重要。在构建可视化层之前,Raducu 会要求模型审查它自己建立的知识库。原则上,这能把事实核查与内容呈现分开,使错误更容易定位。然而,这并不会像文章所描述的那样,让结果“百分之百准确”。模型审查自己的输出时,仍可能重复同一个错误假设、遗漏相关来源,或把过度简化视为可以接受。因此,准确性取决于底层参考资料的质量,也取决于是否有人将这些模拟中的主张与独立材料逐项核对。
GitHub 仓库 `learnscape` 为同一概念提供了更严谨的实现方式。其 README 描述了等距视角的解释作品:一辆载具携带真实的内部状态,每停靠一站都会执行模拟中的一个真实步骤。该仓库还要求建立一份“保真度台账”,把数字明确标为计算所得、按比例缩放、基于假设,或为便于说明而有意虚构。这种区分十分重要,因为精致的外观可能暗示模型其实并不具备的精确性。学习者不仅能看到解释作品提出了什么主张,还能知道哪些部分经过测量、哪些只是近似,哪些是为了清晰说明而人为设定的。
`learnscape` 还记录了具体的工程检查:JavaScript 语法验证,以及在无界面 Chromium 中运行的冒烟测试,覆盖全部八个站点和一次完整的三请求流程。这些检查能够证明所提供的 PacketPost 示例确实按描述运行,却不能验证用这种技术构建的每个主题都具有教育效果。该仓库经过验证的适用范围同样比普遍保证更窄:它说明基于复制的安装方法已经过测试,但端到端插件安装尚未经过测试。这提醒我们,应把能够正常运行的演示,与针对未来所有用途的广泛主张区分开来。
Raducu 的另一个 GitHub 仓库 `unreal-game-assets-creation-skill` 展示了丰富模拟的另一种途径:把提示词或照片转换成带纹理的三维资产。其 README 描述了一条使用 Fooocus、Hunyuan3D-2、Blender,并可选用 Unreal Engine 的流程。它还报告了一项实际限制:在一台配备 RTX 4070 笔记本 GPU 和 8 GB 显存的 Windows 工作站上,同时运行图像服务与三维服务会造成内存压力,并显著拖慢生成速度,因此该技能会在启动下一项服务前停止前一项服务。这只是有关该仓库所记录配置环境的证据,并不是针对所有硬件或 AI 生成工具的通用基准测试。
对于考虑采用这种方法的读者,最站得住脚的不是某种结论,而是一套操作流程:用 LLM 起草主题地图,质疑并检验这份地图,实现一个行为可被观察的小型模型,并持续维护一份明确的假设记录。只有当底层过程已经得到充分呈现、能够支撑相应内容时,才加入问题或谜题。可视化层应当澄清模型,而不是掩盖不确定性。因此,这套工作流最可靠的形式不是“相信动画”,而是“让主张变得可执行,然后检查执行结果在哪些地方与证据不一致”。
源材料将主要文章日期标为 2026 年 8 月 9 日,与页面提供的发布日期一致。文章关于个人实用性和准确性的说法,仍是作者本人的陈述。所提供的仓库证实相关工具和文档确实存在,并补充了有关模拟结构、保真度标签、测试以及本地 GPU 限制的细节。它们既没有证明比较性的学习成果,也没有证明 ChipTycoon 不存在幻觉,更没有表明每一个由 LLM 生成的解释作品都可靠。对读者而言,这种方法有望成为一种组织探究过程的手段,但其教育价值仍须结合学习者的目标、资料来源以及发现错误的能力加以检验。