在 8 位 PC 时代,图形硬件缺乏现代功能,如纹理映射或位块传输(blitter),这迫使程序员必须手动移动屏幕缓冲区的每一个字节才能渲染出一个帧。为了让一款横向滚动游戏在 6809 处理器上可运行,一名开发者将原本耗时 157 个周期的简单行复制循环,改为一种专门的基于堆栈的黑科技,仅用 56 个周期即可执行相同的操作。
硬件限制
在 20 世纪 80 年代,PC 图形硬件几乎不提供数据移动方面的协助。为了显示横向滚动游戏,程序员必须将 28x28 像素的瓦片逐字节复制到 320x240 的屏幕缓冲区。由于屏幕缓冲区比瓦片宽,每次行复制都需要特定的内存偏移计算来推进目标指针。
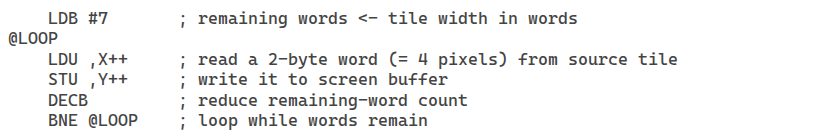
此截图展示了 8 位时代所需的手动内存管理。
“我设法利用了机器上每一个可用的寄存器”
— A Great Old-Timey Game-Programming Hack - Tom Moertel’s Blog
迭代式汇编优化
第一个优化涉及展开内层循环,以消除用于复制一行字数的 7 次计数循环带来的开销。这使周期数从 157 减少到 120,速度提升了 30%。
由 HN Digest 根据 blog.moertel.com 报告的数据绘制;数值按原文显示。
下一步涉及将 3 周期的后置递增操作替换为 1 周期的精确偏移。通过计算每个字相对于源和目标寄存器的精确位置,开发者将行复制成本降低到 98 个周期,比原始代码提高了 60%。
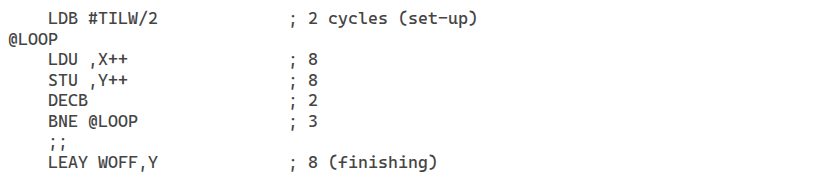
代码列表显示了从简单循环到优化汇编指令的转变。
堆栈与直接页黑科技
最极端的优化利用了 6809 独特的架构。该处理器具有 PSHS 和 PULS 指令,可以在极少的周期内将所有寄存器压入或弹出到硬件堆栈。通过将堆栈寄存器(S 和 U)指向背景瓦片和屏幕缓冲区,开发者可以移动大块数据。
为了处理 28 像素行(14 字节)不能被 6 整除的情况,开发者利用了 6809 的“直接页”寄存器。通过将特定的内存页指定为“直接页”,DP 寄存器可以充当额外的单字节中转站,允许代码在每次压入-弹出对中复制 7 个字节。这种最终方法将行复制操作减少到仅 56 个周期。
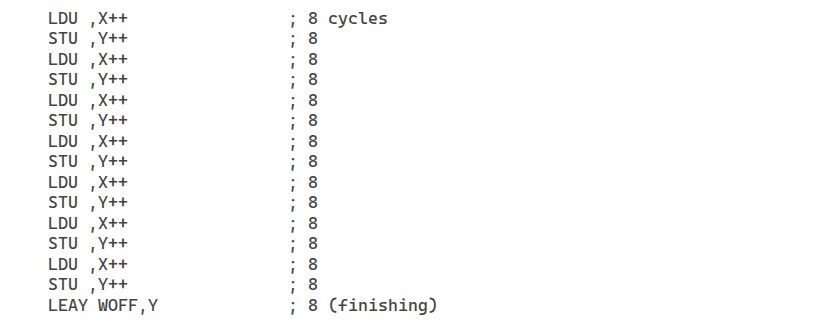
此列表展示了实现 56 周期行复制的“疯狂”黑科技。
其他性能策略
虽然 6809 黑科技侧重于加快复制操作,但其他开发者通过改变需要复制的内容来解决同样的性能瓶颈。诸如“脏矩形”或自适应瓦片刷新的技术涉及跟踪游戏状态的变化,并且仅重新绘制移动的特定像素或瓦片,而不是每一帧都刷新整个屏幕。